薄い集合による全偶数のゴールドバッハ型表現:計算実験
はじめに
はじめまして、お邪魔します。
自分は数学が苦手です。それでも数の世界にうっすらとした関心があります。
このたび趣味の程度でゴールドバッハ予想に関連する計算実験をしたモノがあるので、当Mathlogに投稿してみた次第です。数学独特の用語や表現について無知なので、誤解が生じないよう平易な言葉で実験結果だけを書き連ねますが、お付き合い下さると嬉しいです。
※カテゴリに「実験数学」が無かったので取り敢えずコチラのカテゴリに投稿しました
さて、当実験の目的は、「ゴールドバッハ型表現は、数の密度・分布が素数定理とは異なっていて、かつ合成数を含む集合についても可能なのでは?」という疑問に計算実験を通じて答えを近づけることです。
ここでゴールドバッハ型表現とは、偶数mをm=a+b(a,bは集合の要素で a=bも可)と表すことを言ってます。
またゴールドバッハ(型)表現数はa≦bのペアの数で数えます(3+5と5+3を区別しません)。
※手元のiPhone SE3、iPad Air2でPythonista3コードを実行して調べました
使用したコードは末尾のリンク先(GitHub)にあります
扱う集合
次の2種類の集合を用いて比較実験します。
そのままの集合だと面白くないので、両者を同じ貪欲法による篩処理に通して「破壊」した後に残った要素の数とその分布、及び指定された範囲内の全偶数をその残った要素で覆うときの表現数を調べます。
[1]素数集合:
3以上の素数。2は基底として別に扱います。
[2]奇数上のCramér型集合:
各奇数について、その近傍の適応的な区間内における素数の近似的な割合を推定し、その割合にdensity_scaleを乗じた確率で独立に採用(乱数seedの選択により再現性あり)することで生成したランダム部分集合です(初期の穴を防ぐため3,5,7は必ず採用してます)。
採用した貪欲法篩アルゴリズム
6以上の偶数について1つずつ表現の可否を判定しながら、同時に篩処理していきます(偶数4は基底の2を使って2+2としてます)。
よってアルゴリズムは判定対象の最大値を指定すれば、[1]~[4]の手順で篩処理前の集合(以下、プール)から、6以上かつ判定対象の最大値以下のすべての偶数がゴールドバッハ型表現を持つような部分集合を作ります。この部分集合の要素を「生存要素」と呼ぶことにします。
※勿論これは真に最小の部分集合を保証するものではないです
[1]最初の生存要素はプールの最小の要素{3}だけです。
[2]偶数m=6,8,10,...,"判定対象の最大値"を小さい順に調べます。
[3]現時点での生存要素であるqについて、r=m-qを小さなqから順に調べます。これは(a)(b)で共通です。
・(a) rも生存要素であるqが1つでもあれば、mは現状の生存要素で表現可能なので何も変更せず次のmに移行します。
・(b) 生存要素だけではmを表現できない場合、プールに含まれ、かつ、まだ生存要素でない最初のrを新たに生存要素に追加して次のmに移行します。
[4] 一度決めた生存要素は取り消しません(ロールバックなし)。
※篩い範囲を広げても小さな生存要素の密度がほぼ変わらないことを意図した設計です
数表で使った独自の用語
<使用されたq>
篩アルゴリズムの手順[3]・(b)において生存要素に追加されたrとペアになった生存要素qです。
なお、使用されたqの「個数」のカウントには重複使用を含めません。
<margin>
$\frac{生存要素総数-使用されたqの個数}{生存要素総数}$ ×100
この値が大きいほど篩処理の中断リスクが低いであろうという実験結果に基づいた経験的な指標です。
エラー・失敗のケース等
[1]事前穴チェックNG:
篩処理前のプール全体でも表現できない偶数があるケースです(篩処理はムダなので行いません)。
Cramér型集合ではdensity_scaleが小さいほど頻度が増えます。
[2]中断:
プール全体では表現可能でも、あるmについて篩アルゴリズムの手順[3]が完了できなかったケースです。
(例:Cramér型集合 density_scale=0.9 seed=3 においてm=50で中断します)。
[3]"穴なし"の保証:
中断せずに完走した場合に、表現数0の偶数が無いことが保証されるのはm≦"判定対象の最大値"までです。
[4]densityによる「事前穴チェックNG」「完走」「中断」の個数の違いを、seed番号1~2,000(2,000個)で m≦$10^5$ の範囲で集計しました。
プールが素数集合のときは完走してます。
| 事前穴CK NG | 完走 | 中断 | 中断時のmの最大値 | |
|---|---|---|---|---|
| density=1.0 | 401個 | 1,464個 | 135個(8%) | 356(seed=1,017) |
| density=0.75 | 1,246個 | 580個 | 174個(23%) | 1,152(seed=437) |
| density=0.5 | 1,971個 | 9個 | 20個(69%) | 748(seed=1,667) |
実験結果1 生存要素についてのデータ
次の図1~3は判定対象の最大値 m=$10^6$,$10^7$,$10^8$ の3つについて生存要素数等を調べたものです。
seed番号は自然数の1から昇順に選んでいます。
事前穴チェックをクリアしたseedの中から完走したseedが5つになるまで検証したものです。
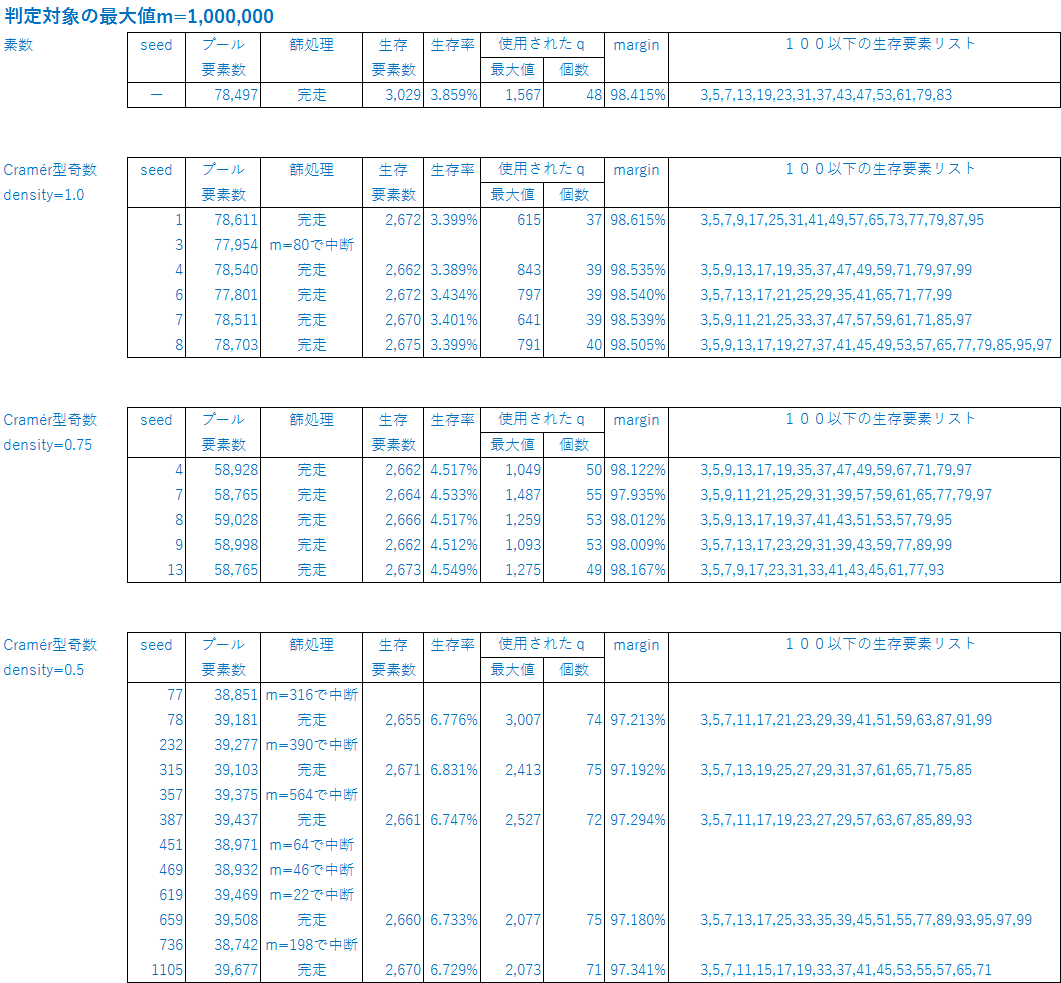 m≦ $10^6$ の範囲の篩処理による生存要素のデータ
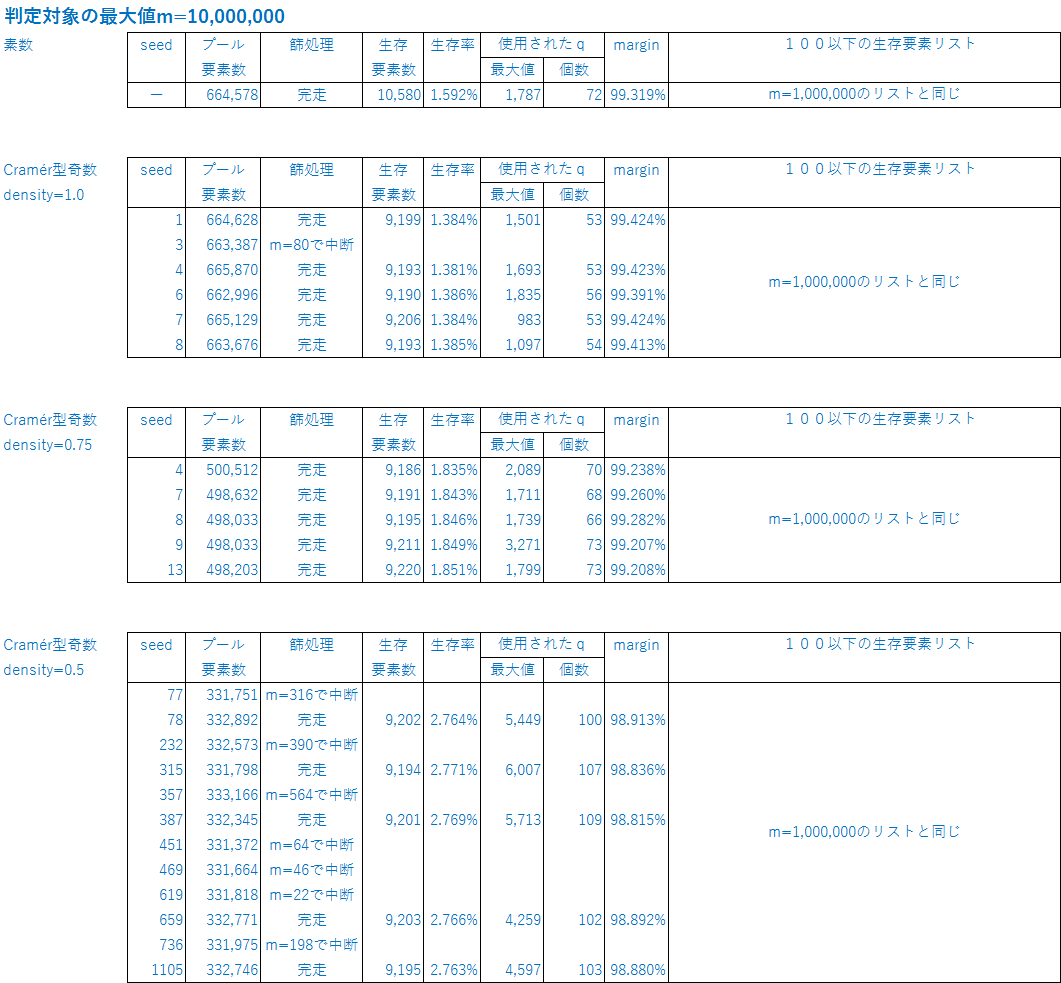 m≦ $10^7$ の範囲の篩処理による生存要素のデータ
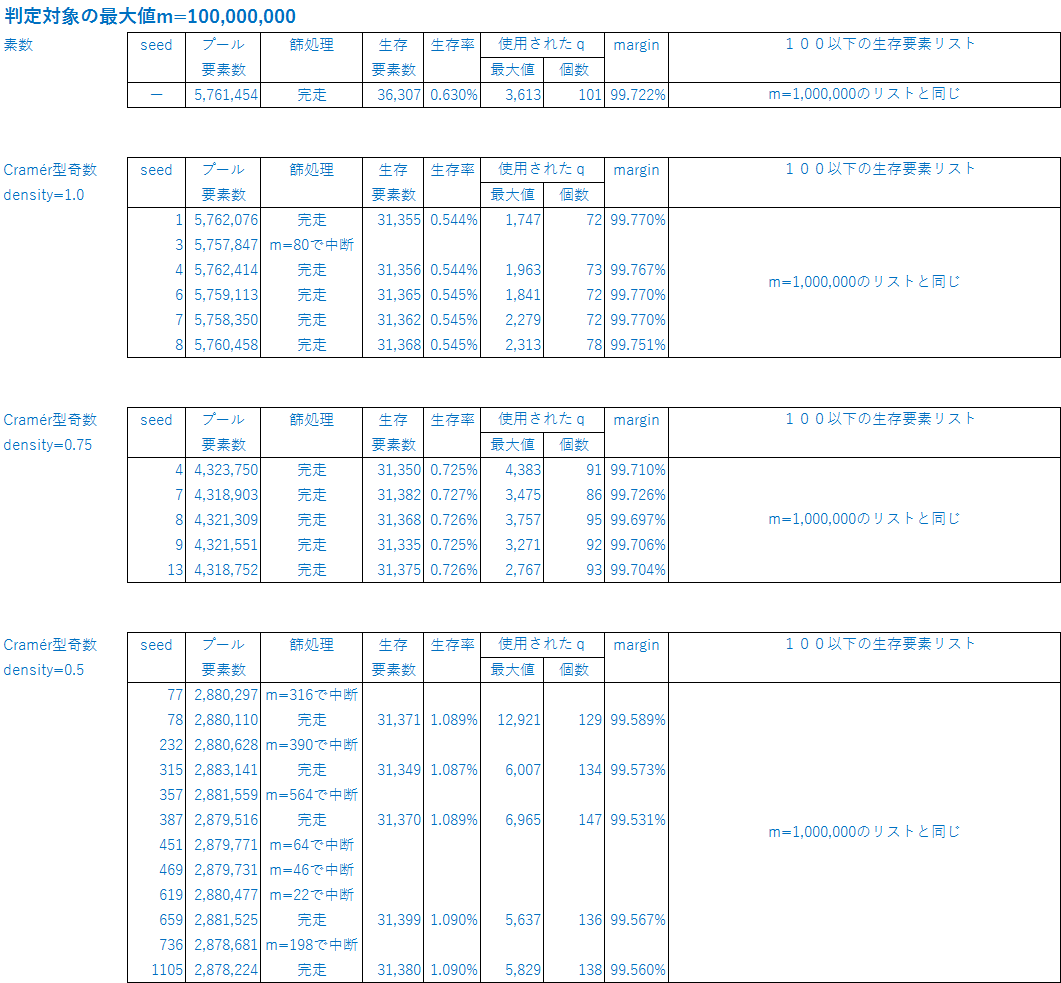 m≦ $10^8$ の範囲の篩処理による生存要素のデータ
次の図4~7の生存要素密度の両対数グラフ(m=$10^8$) は、素数列とCramér型奇数列の各densityから1つずつ選んだものです。
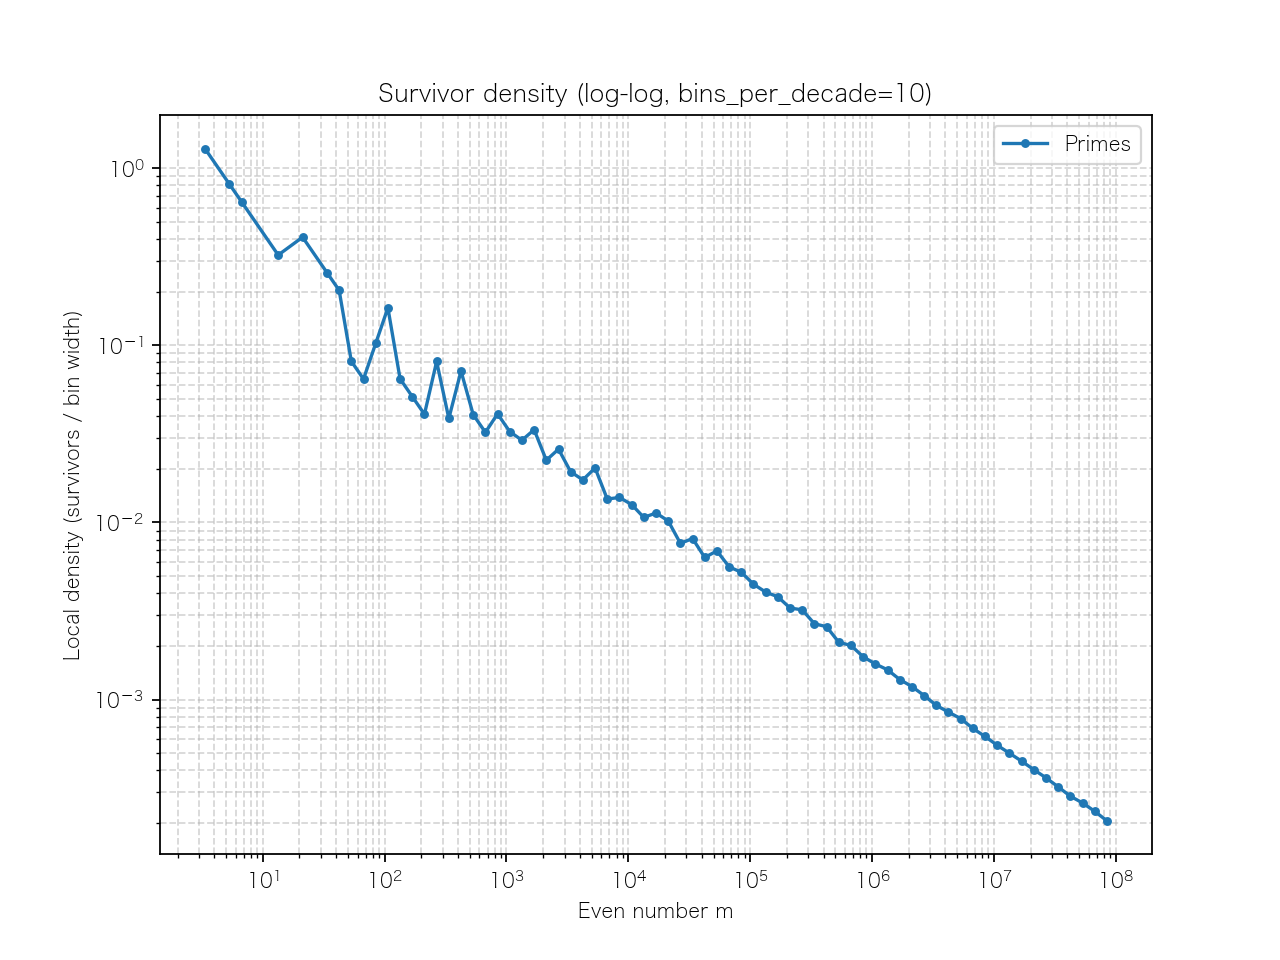 Primes
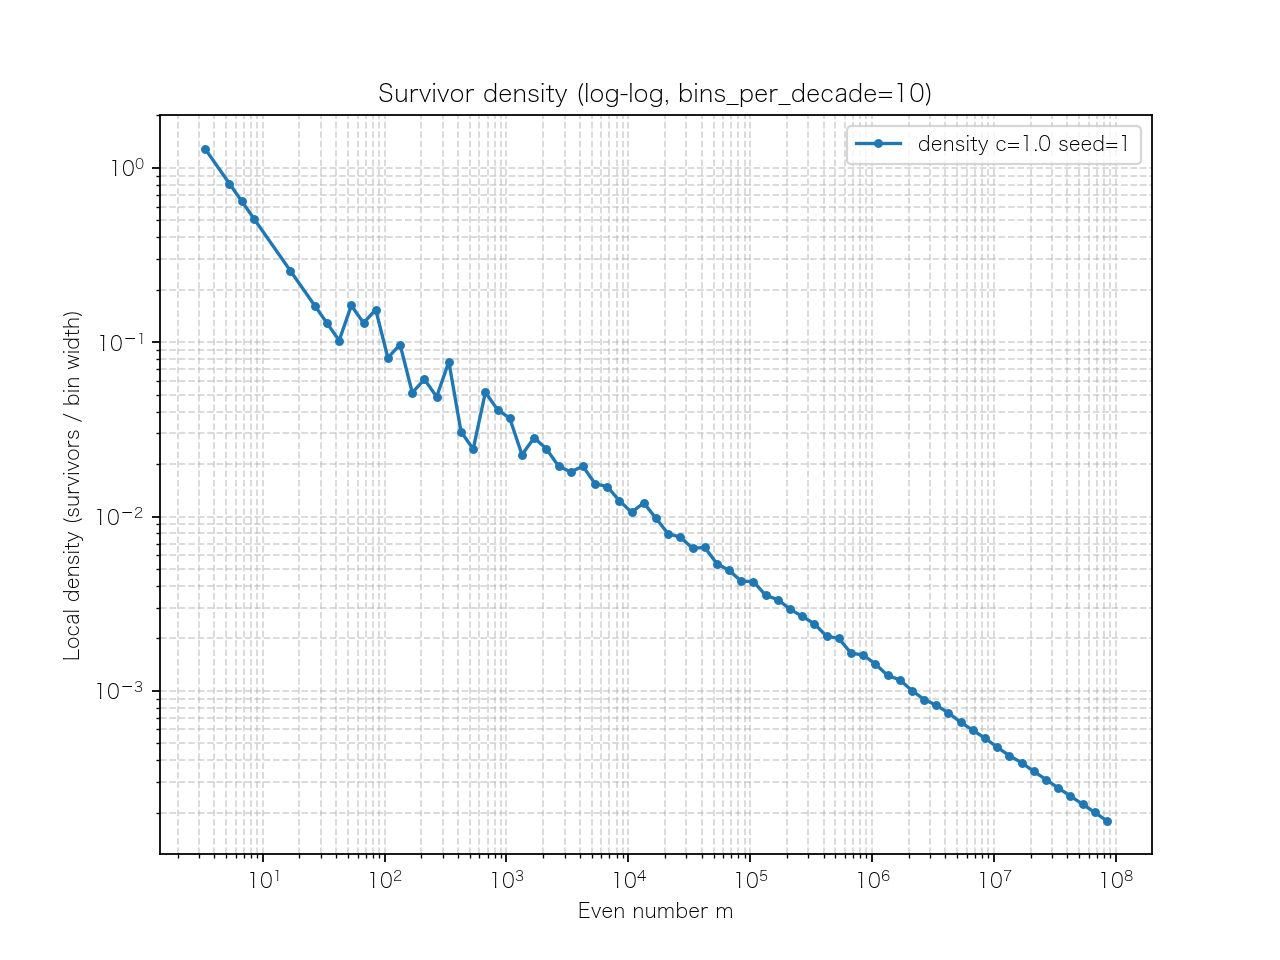 density=1.0 seed=1
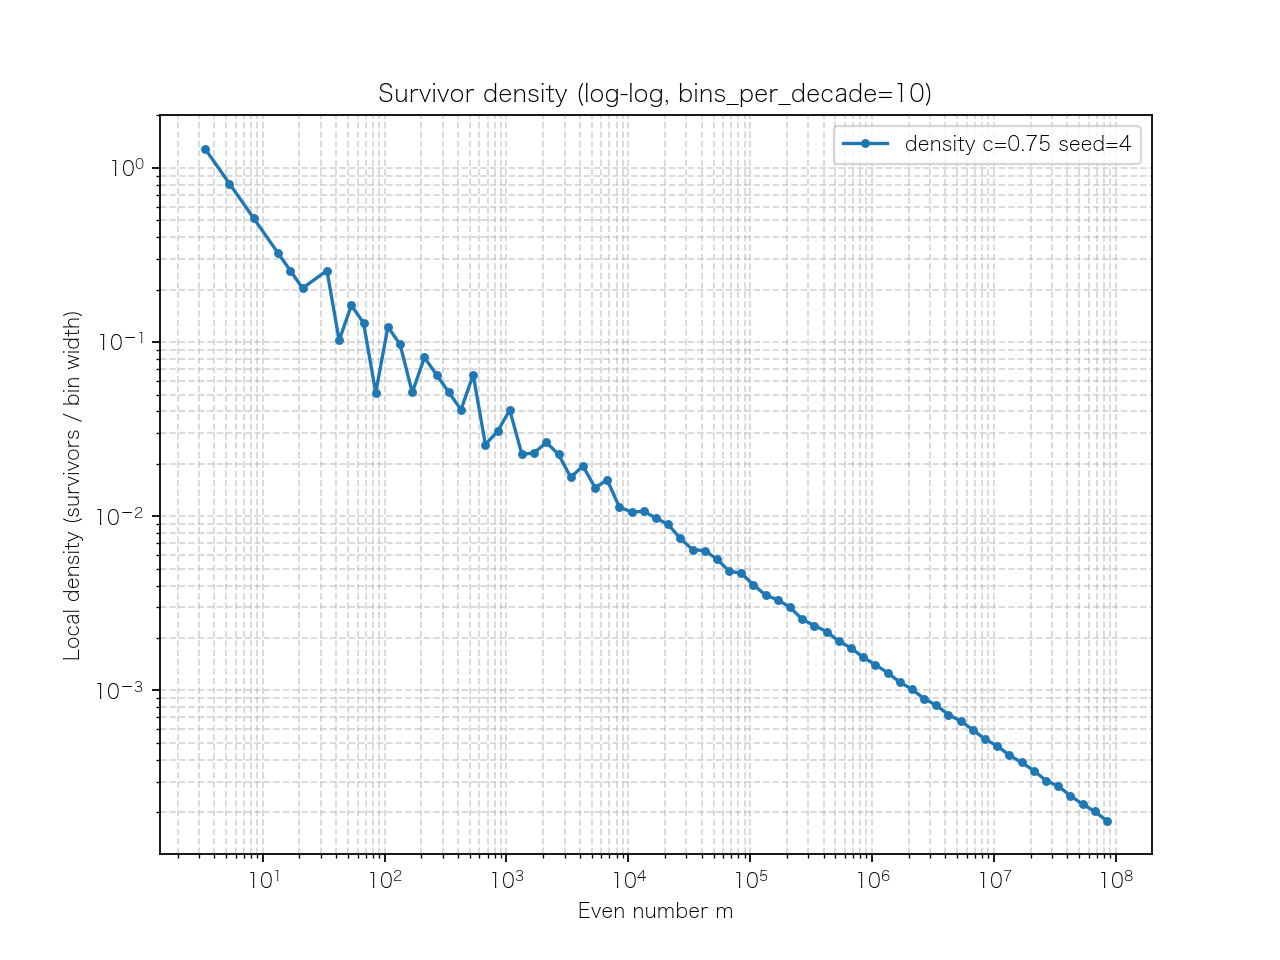 density=0.75 seed=4
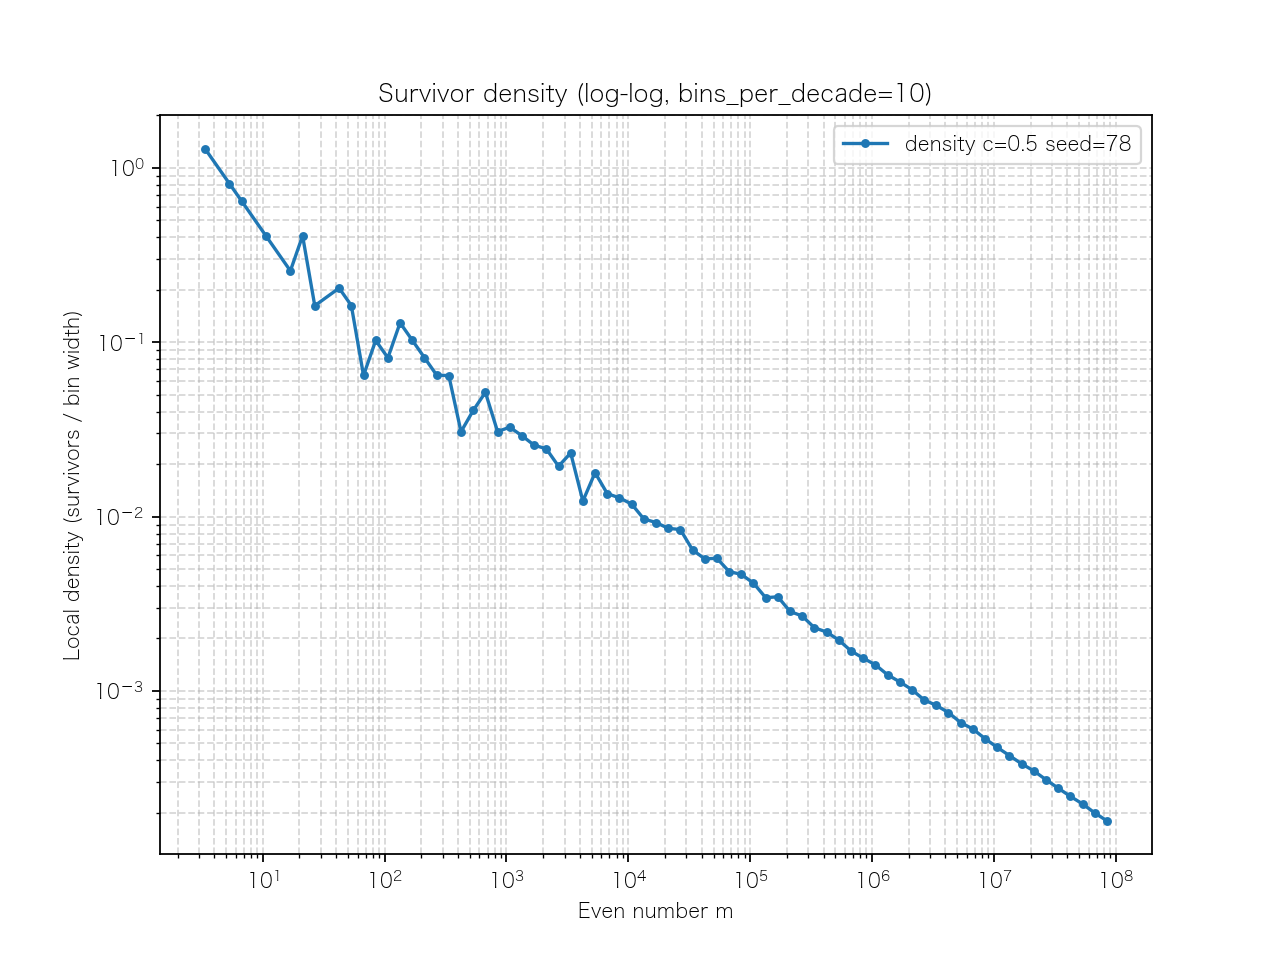 density=0.5 seed=78
実験結果2 篩処理後の表現数についてのデータ
次の図8の上段は、m≦ $10^6$ の範囲の平均表現数等の比較、下段は3つの異なる範囲の平均表現数等の比較です。
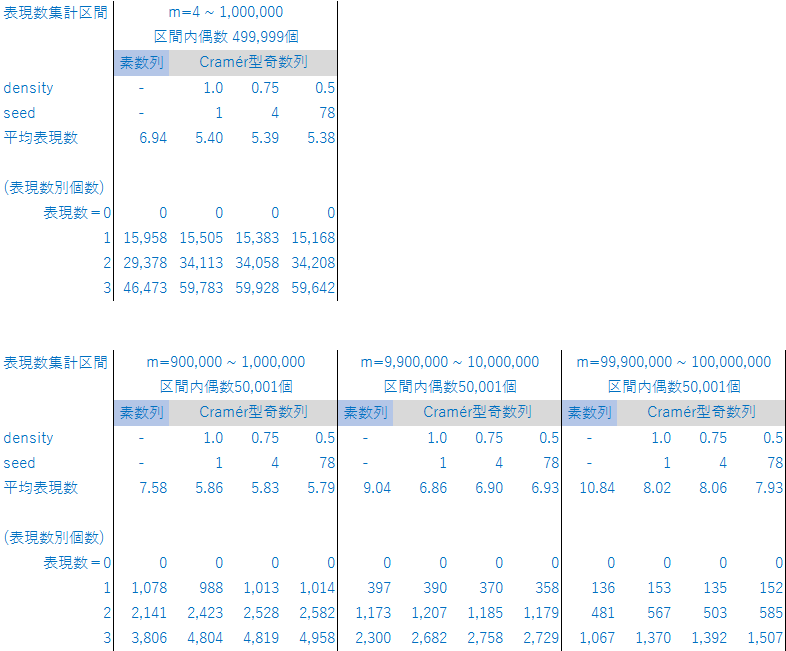 平均表現数の比較
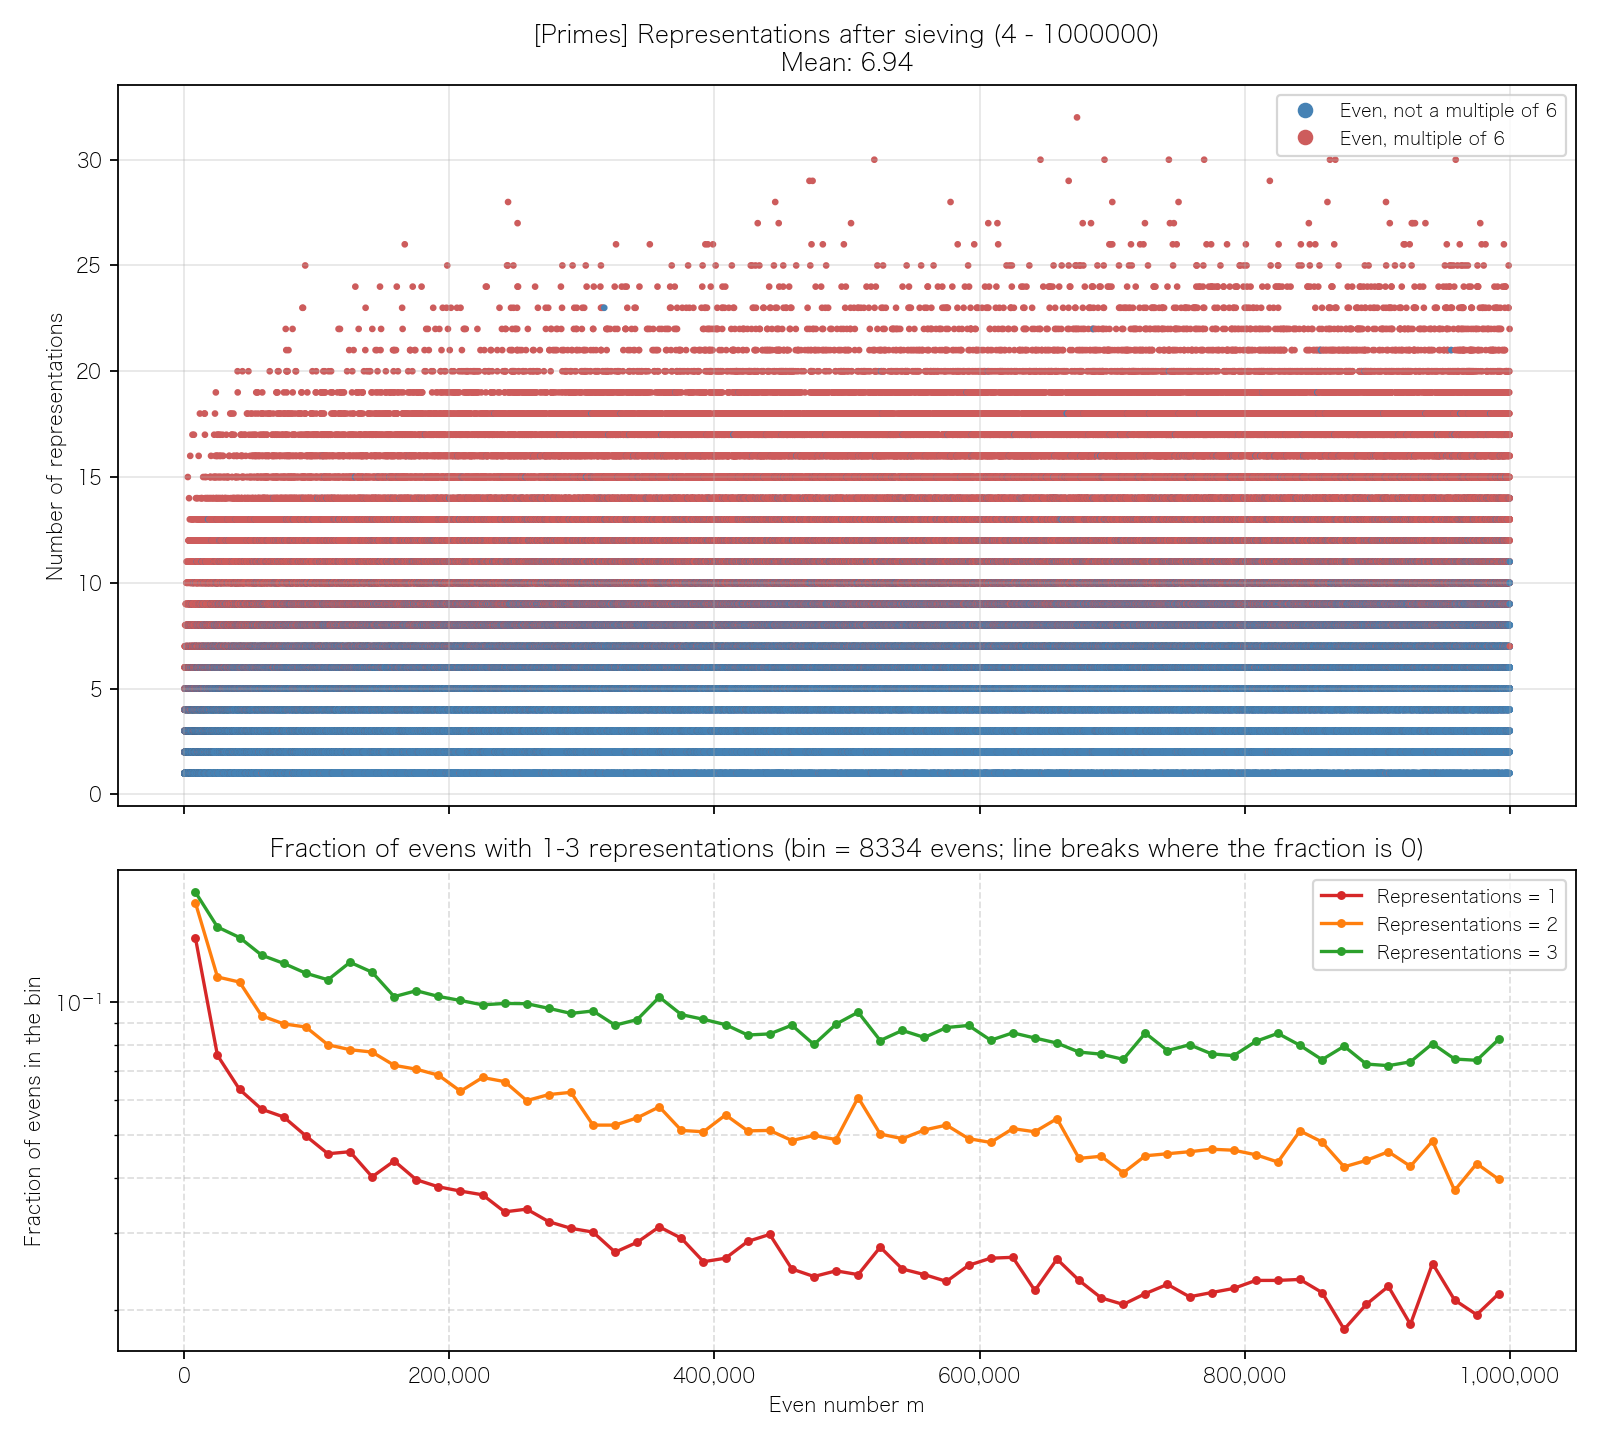
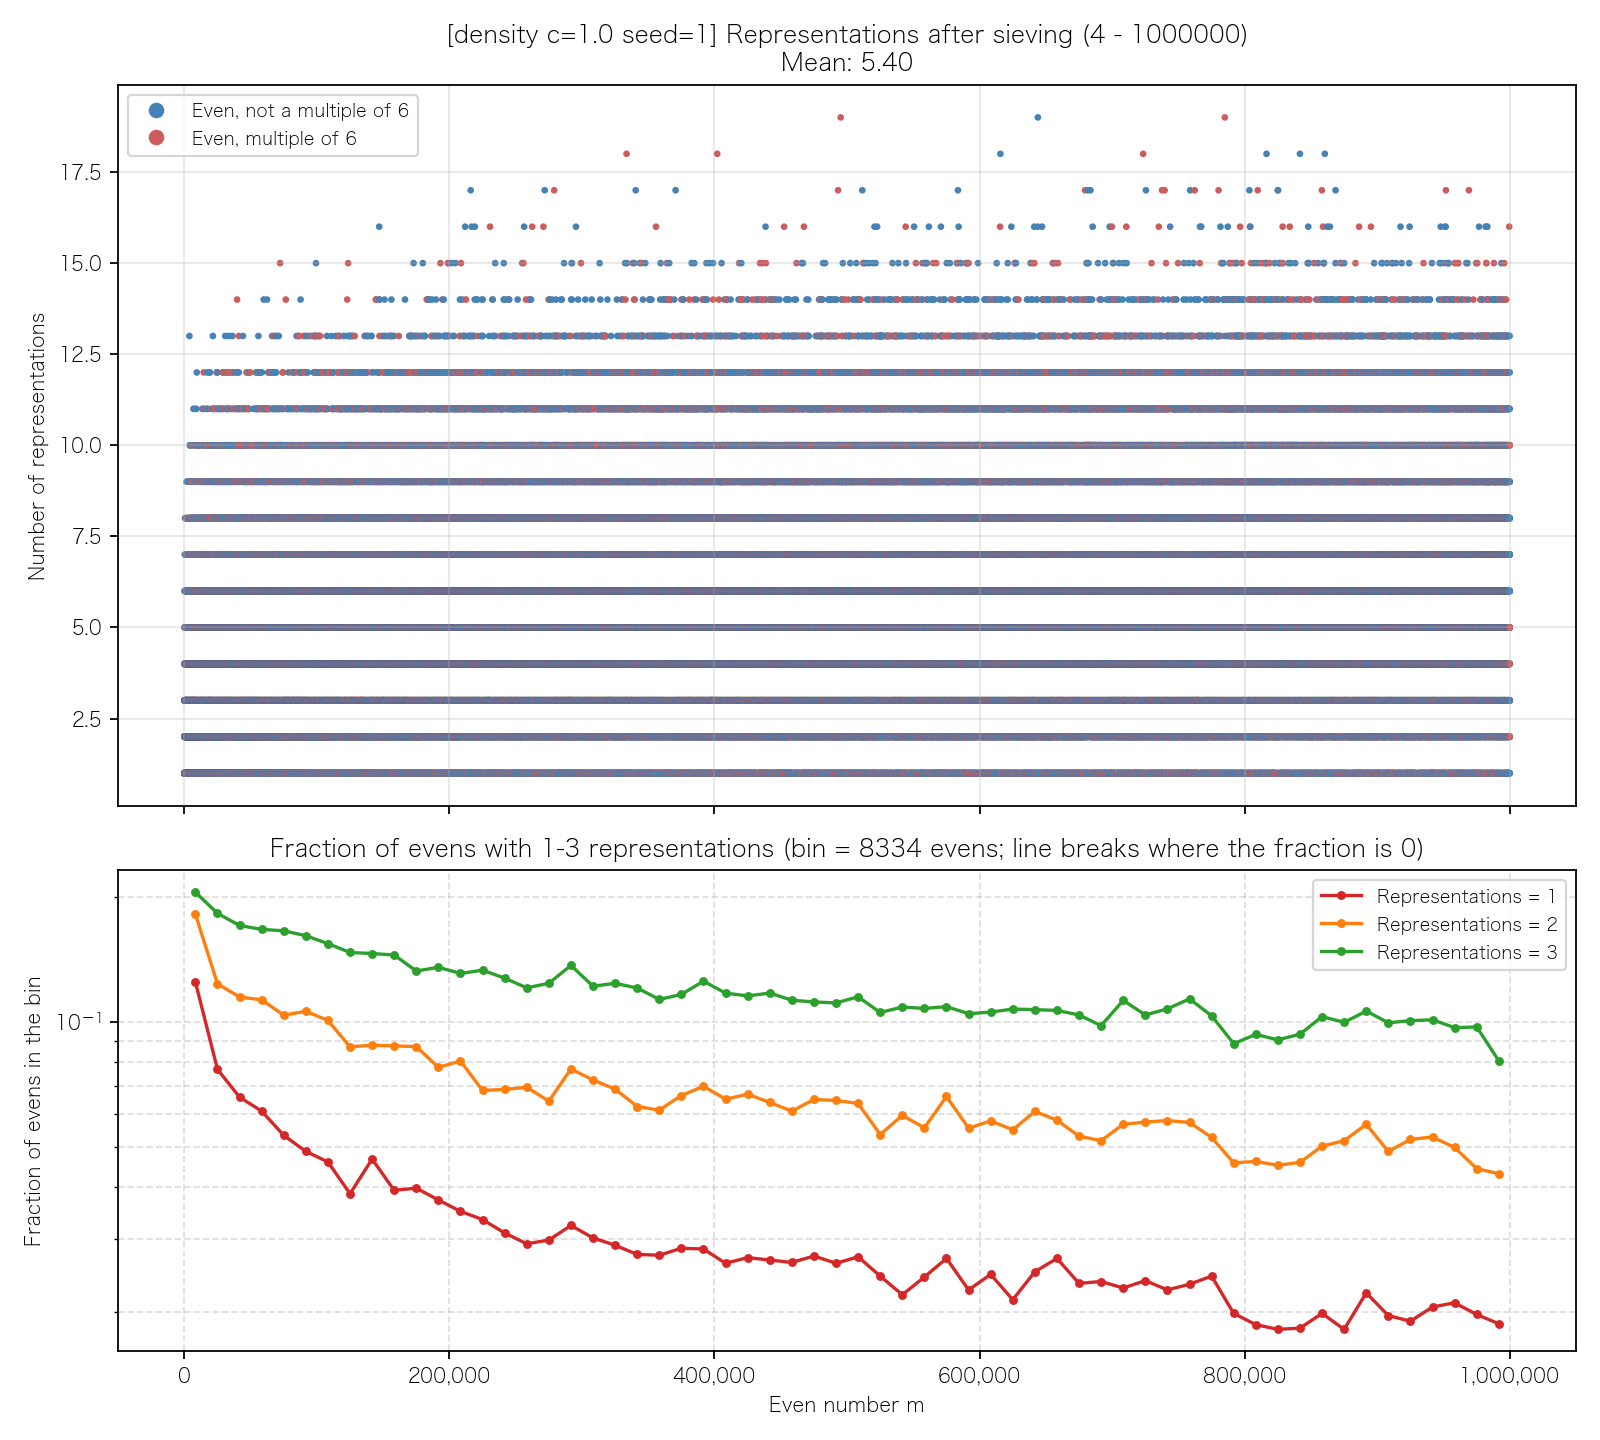
次からの図は、素数列とCramér型奇数列の表現数プロットと、全偶数に対する表現数1,2,3の偶数の割合を表したグラフです。
図9~12はm≦ $10^6$ の範囲、図13~16は9.99 × $10^7$ ≦m≦ $10^8$ の範囲、図17,18はm≦ $10^5$ の範囲だけを篩処理したm≦3 × $10^5$ の範囲のものです。
※表現数が0に見える箇所がありますが実際は穴はありません
 Primes
 density=1.0 seed=1
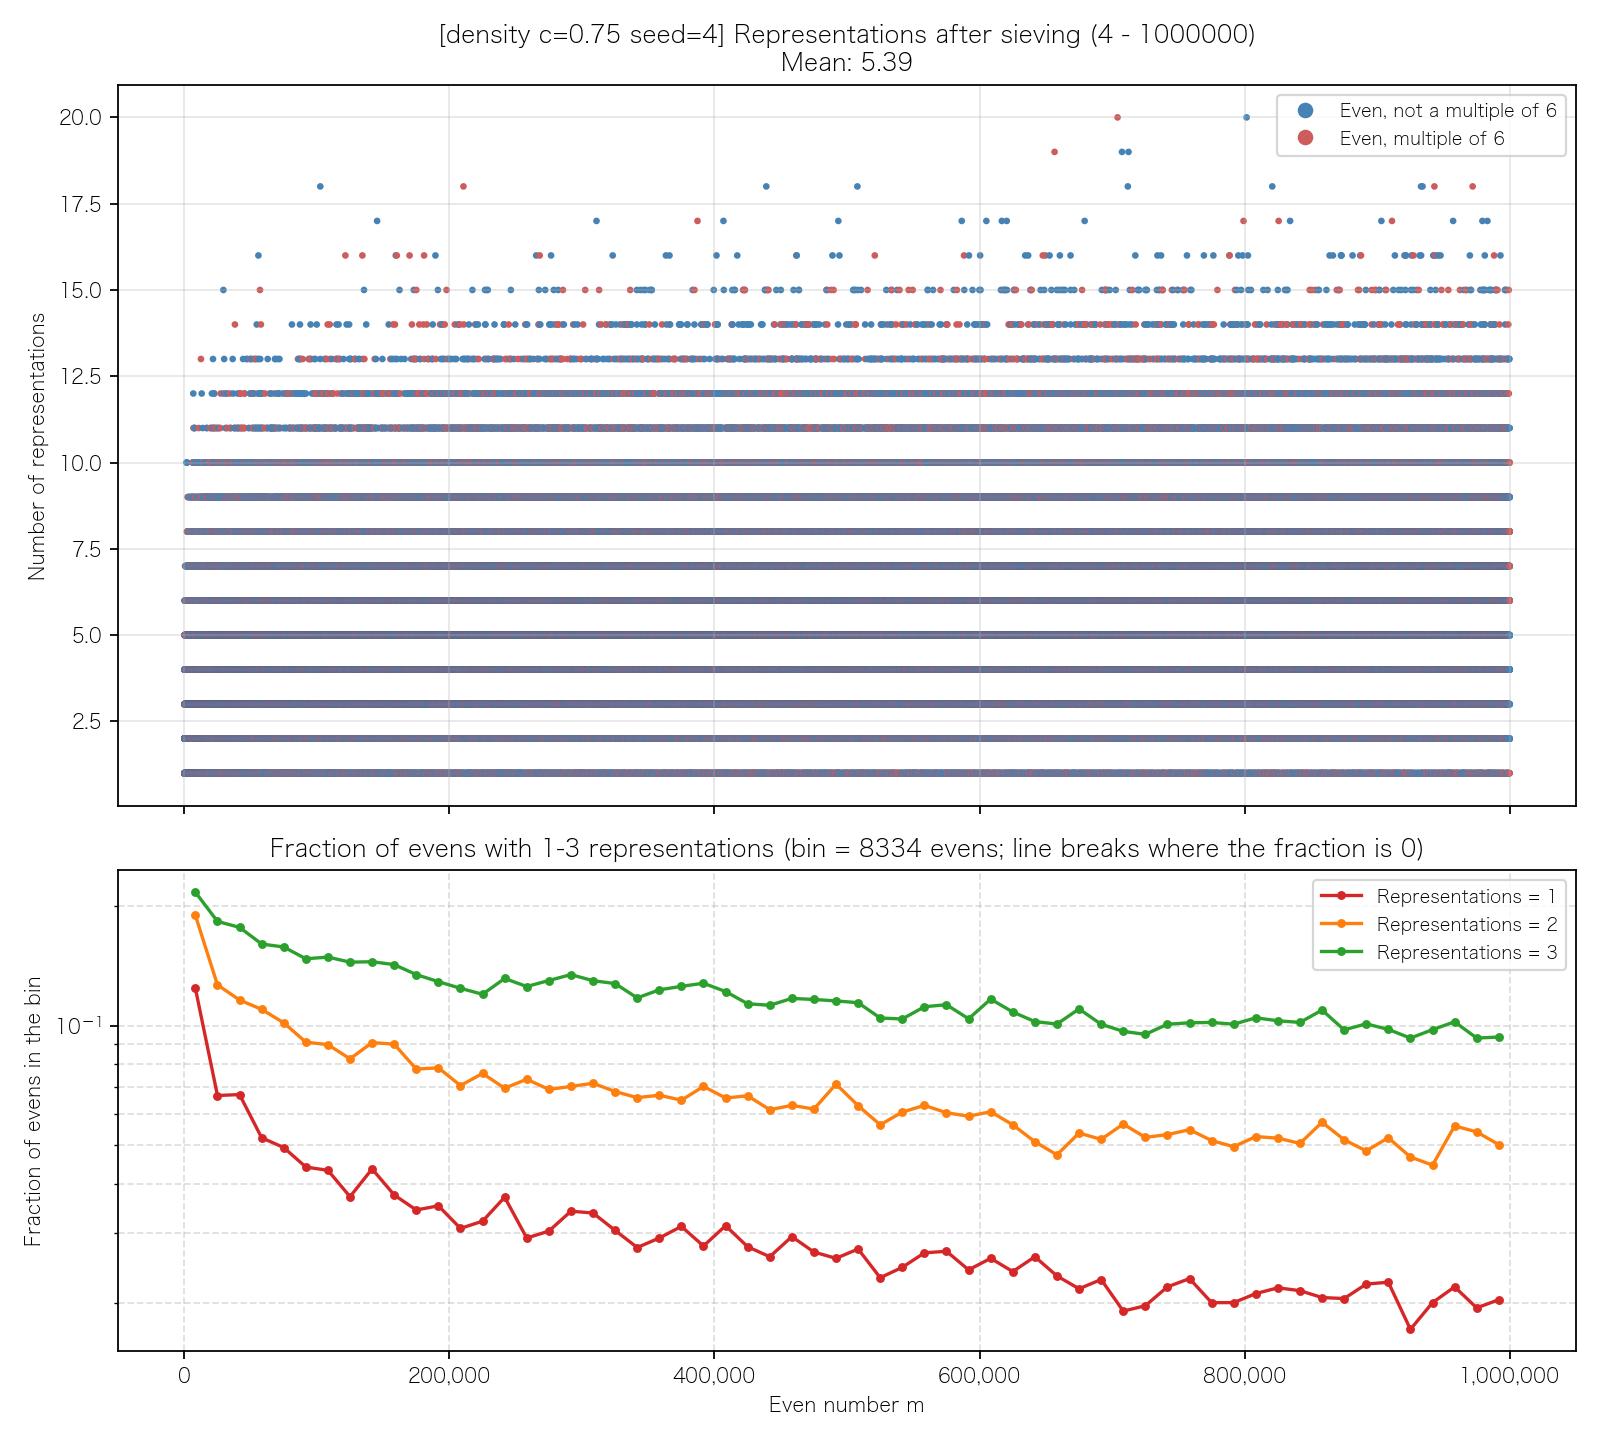 density=0.75 seed=4
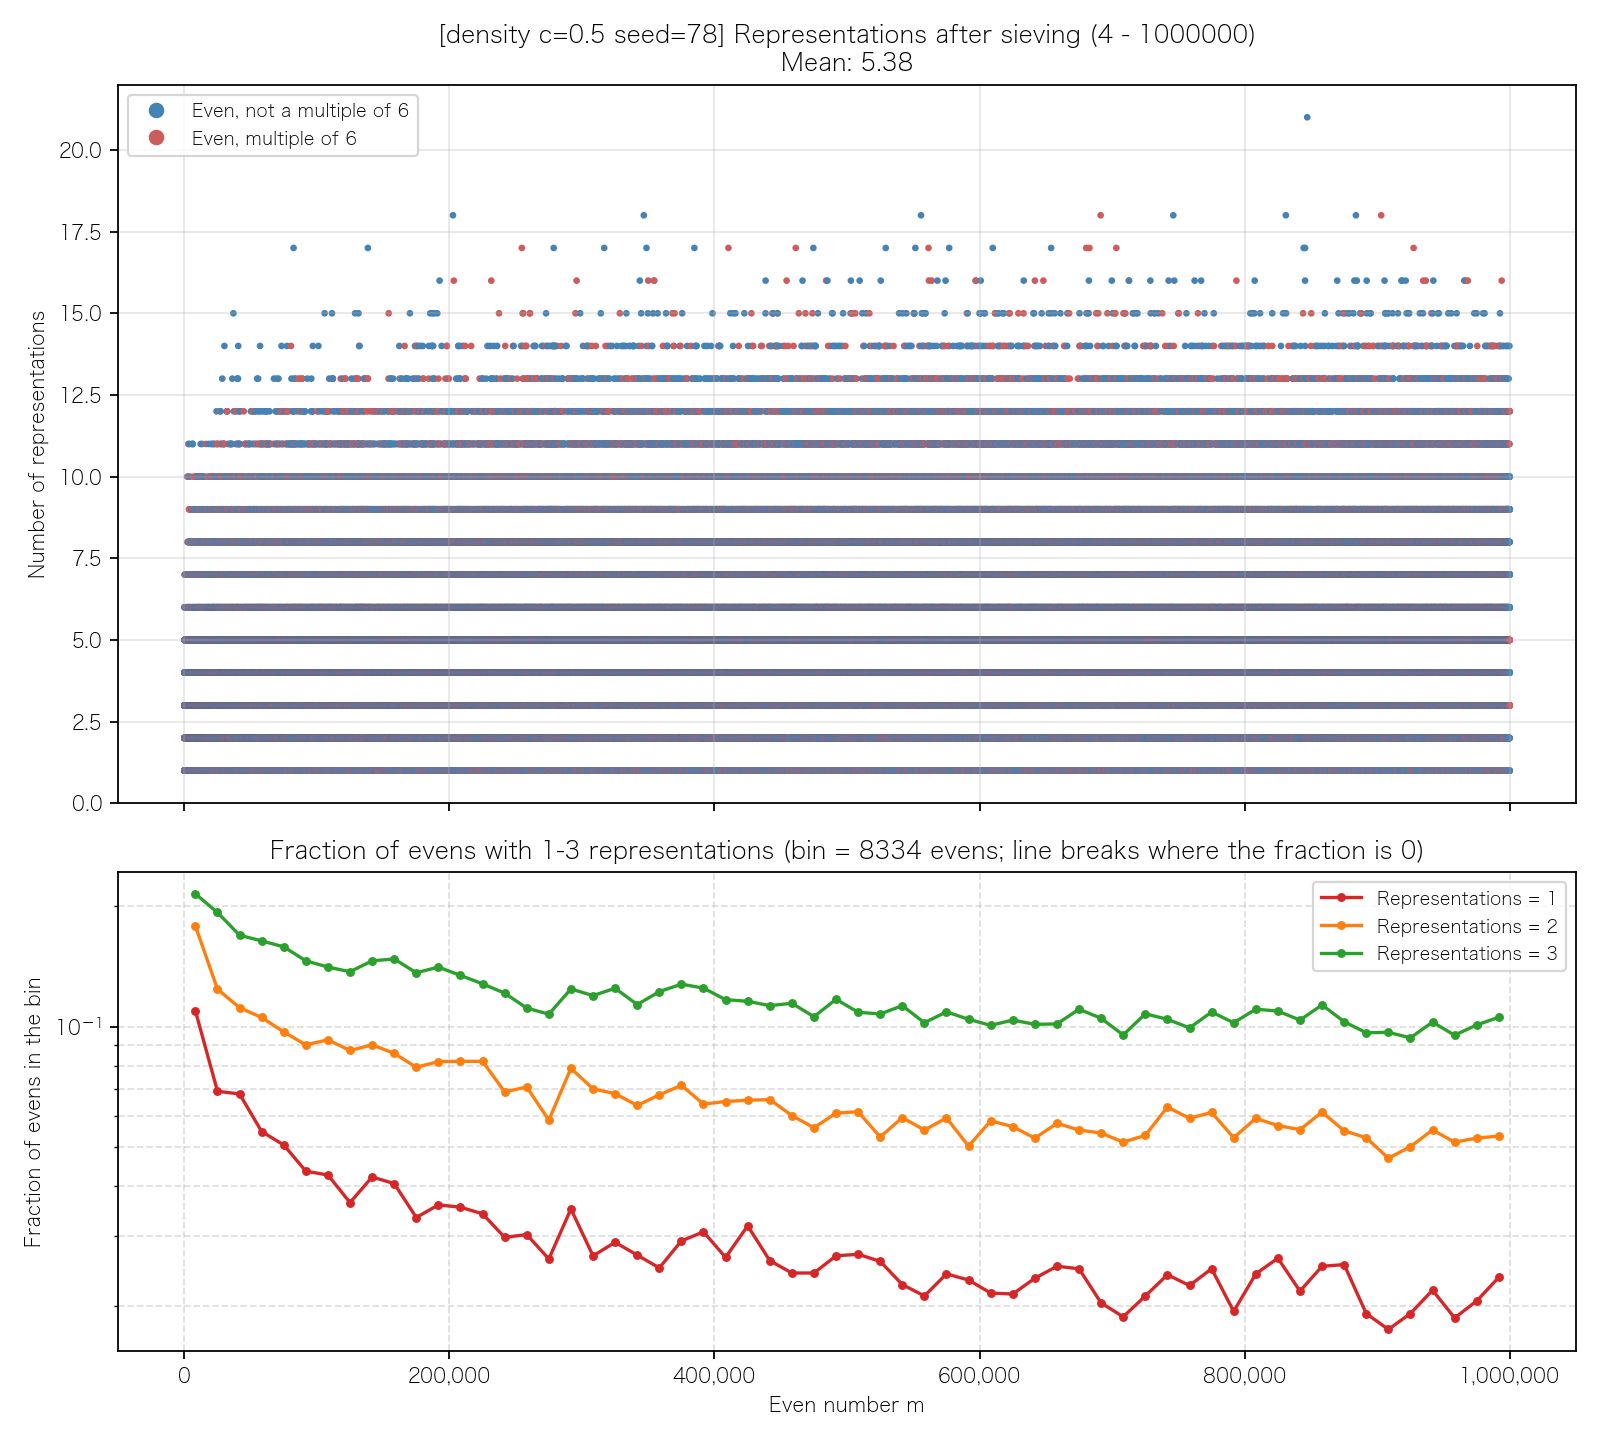 density=0.5 seed=78
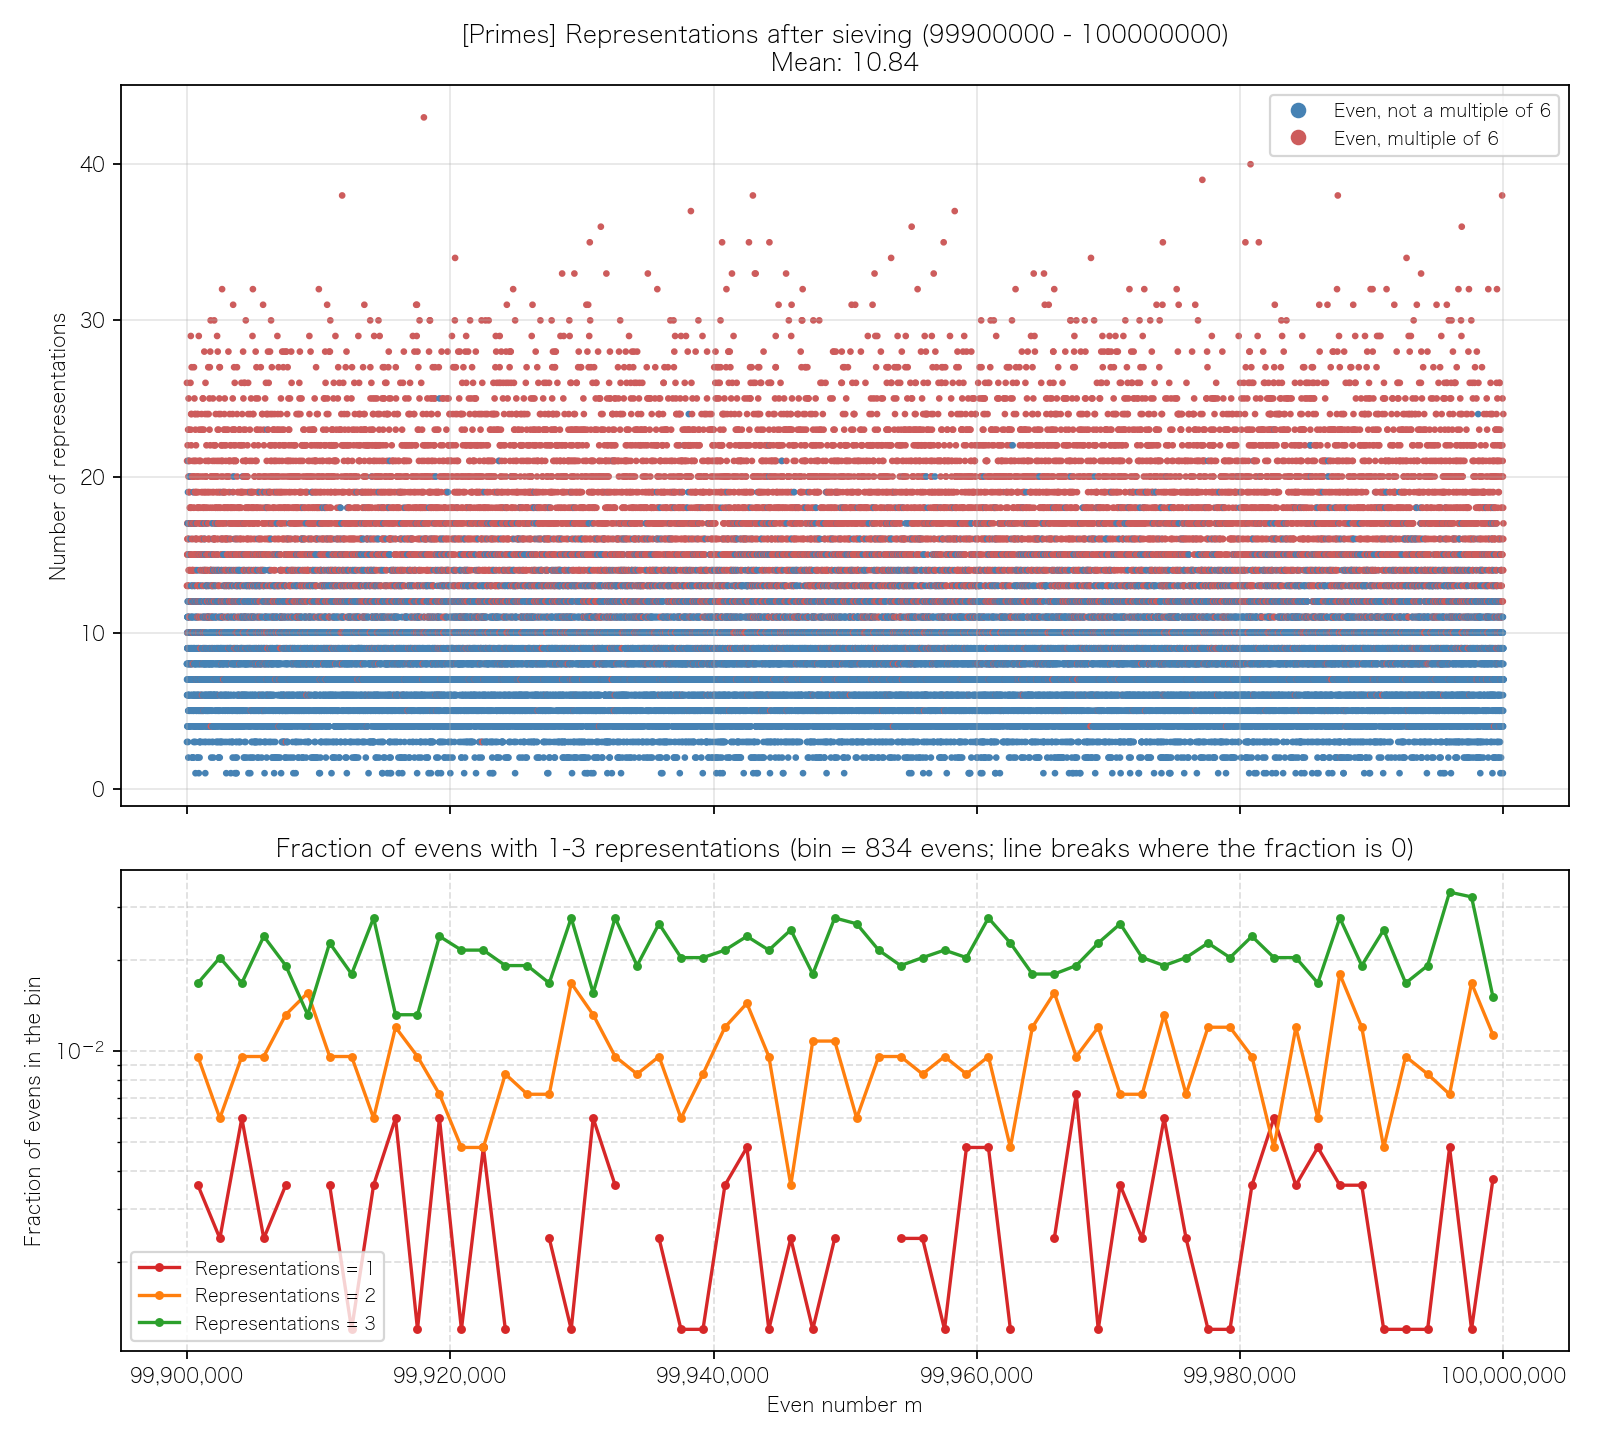 Primes
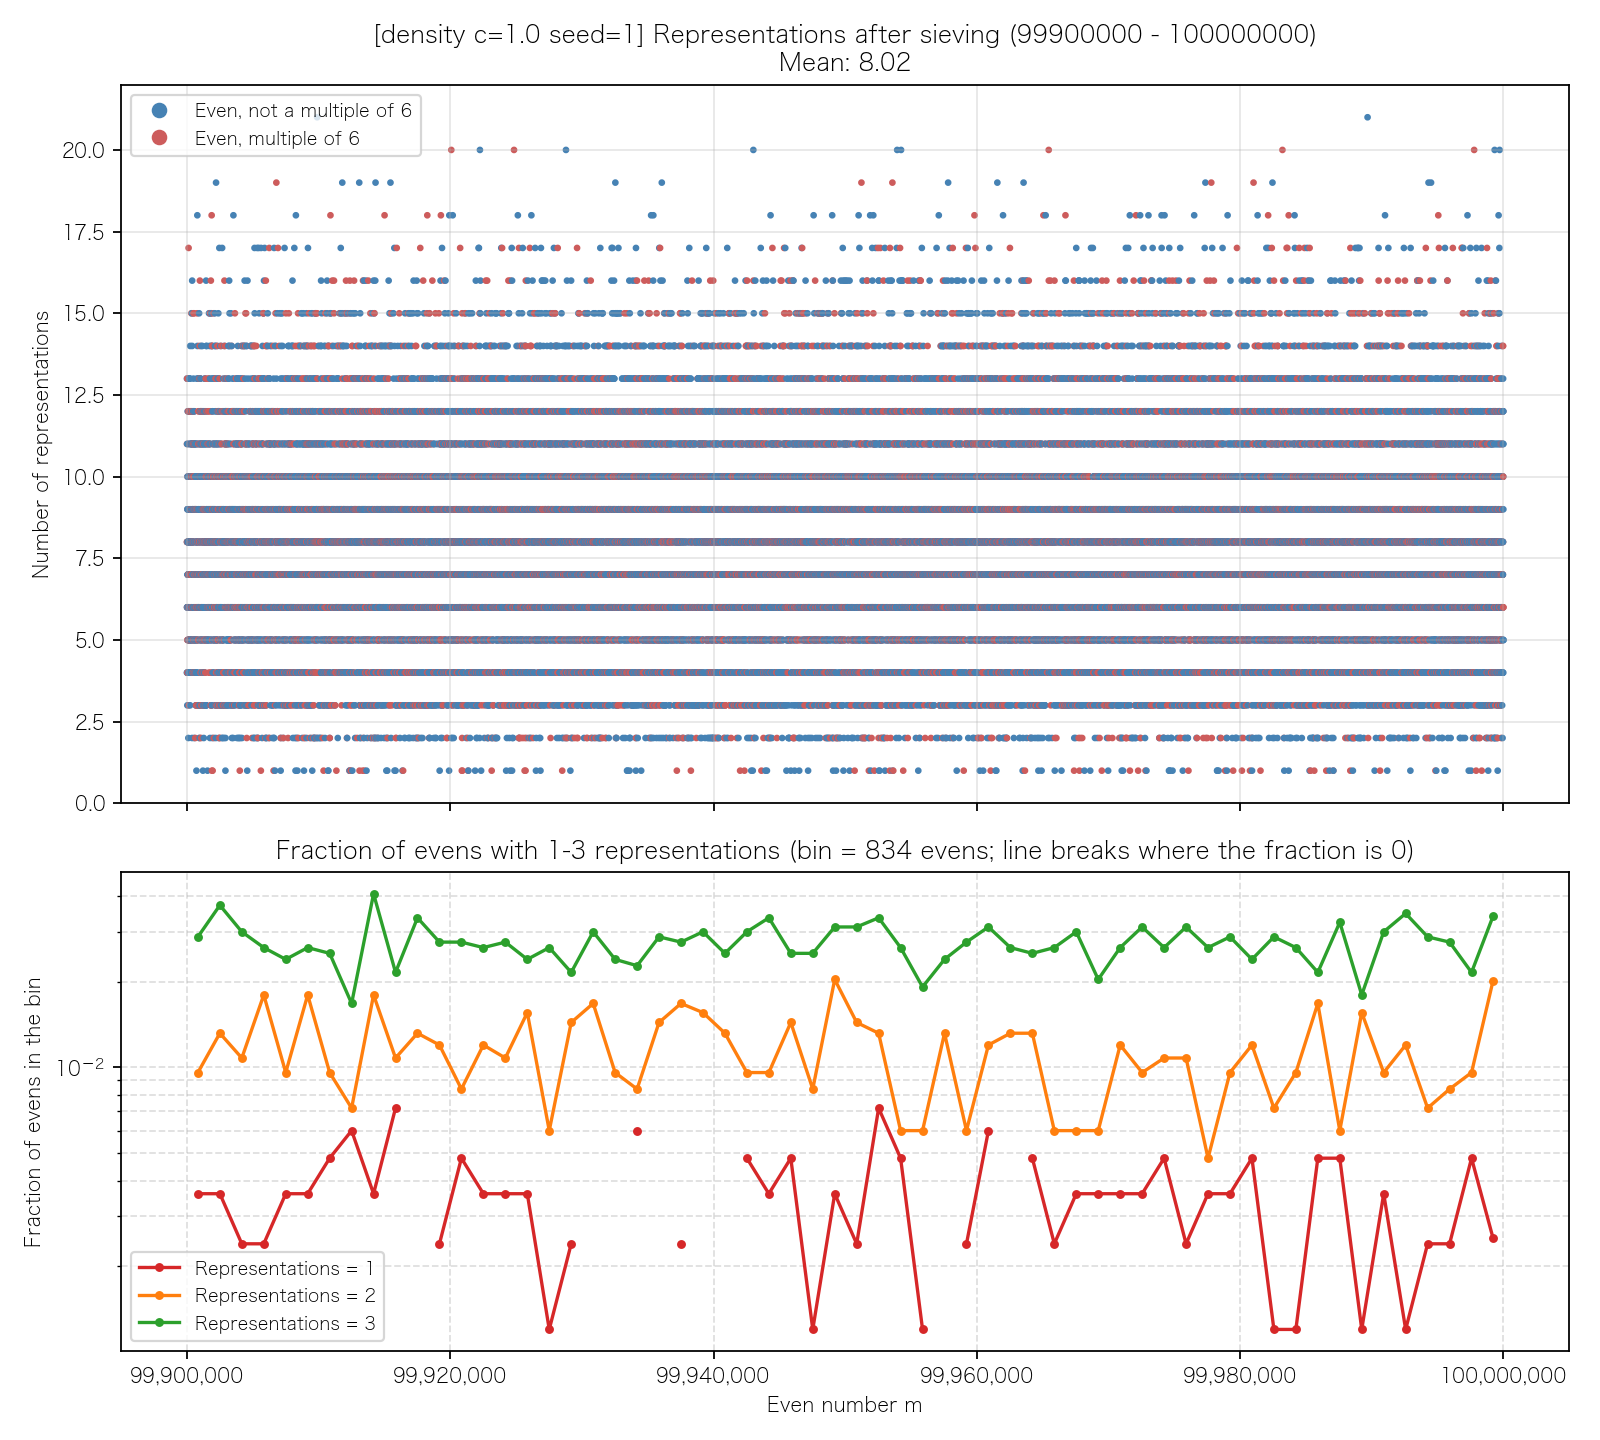 density=1.0 seed=1
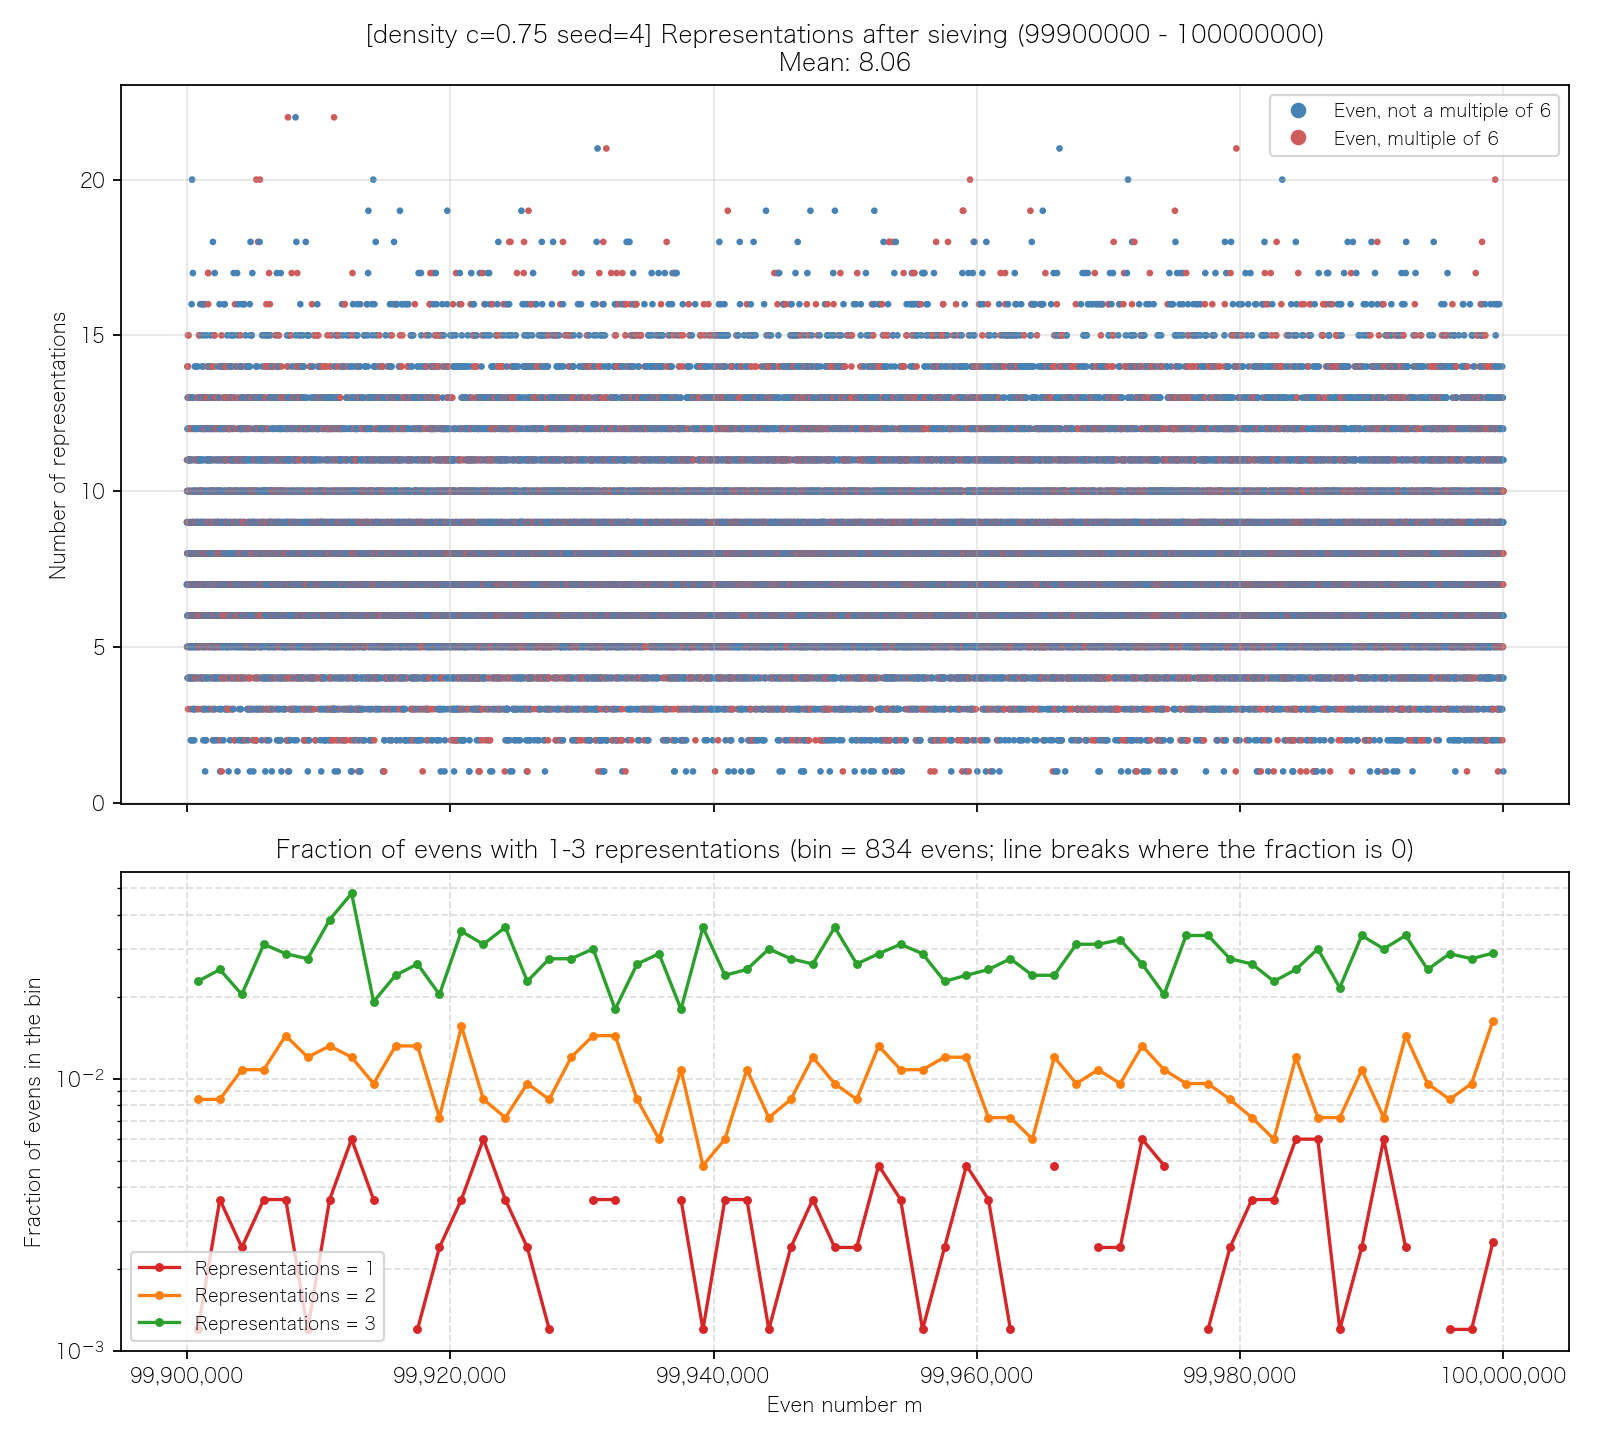 density=0.75 seed=4
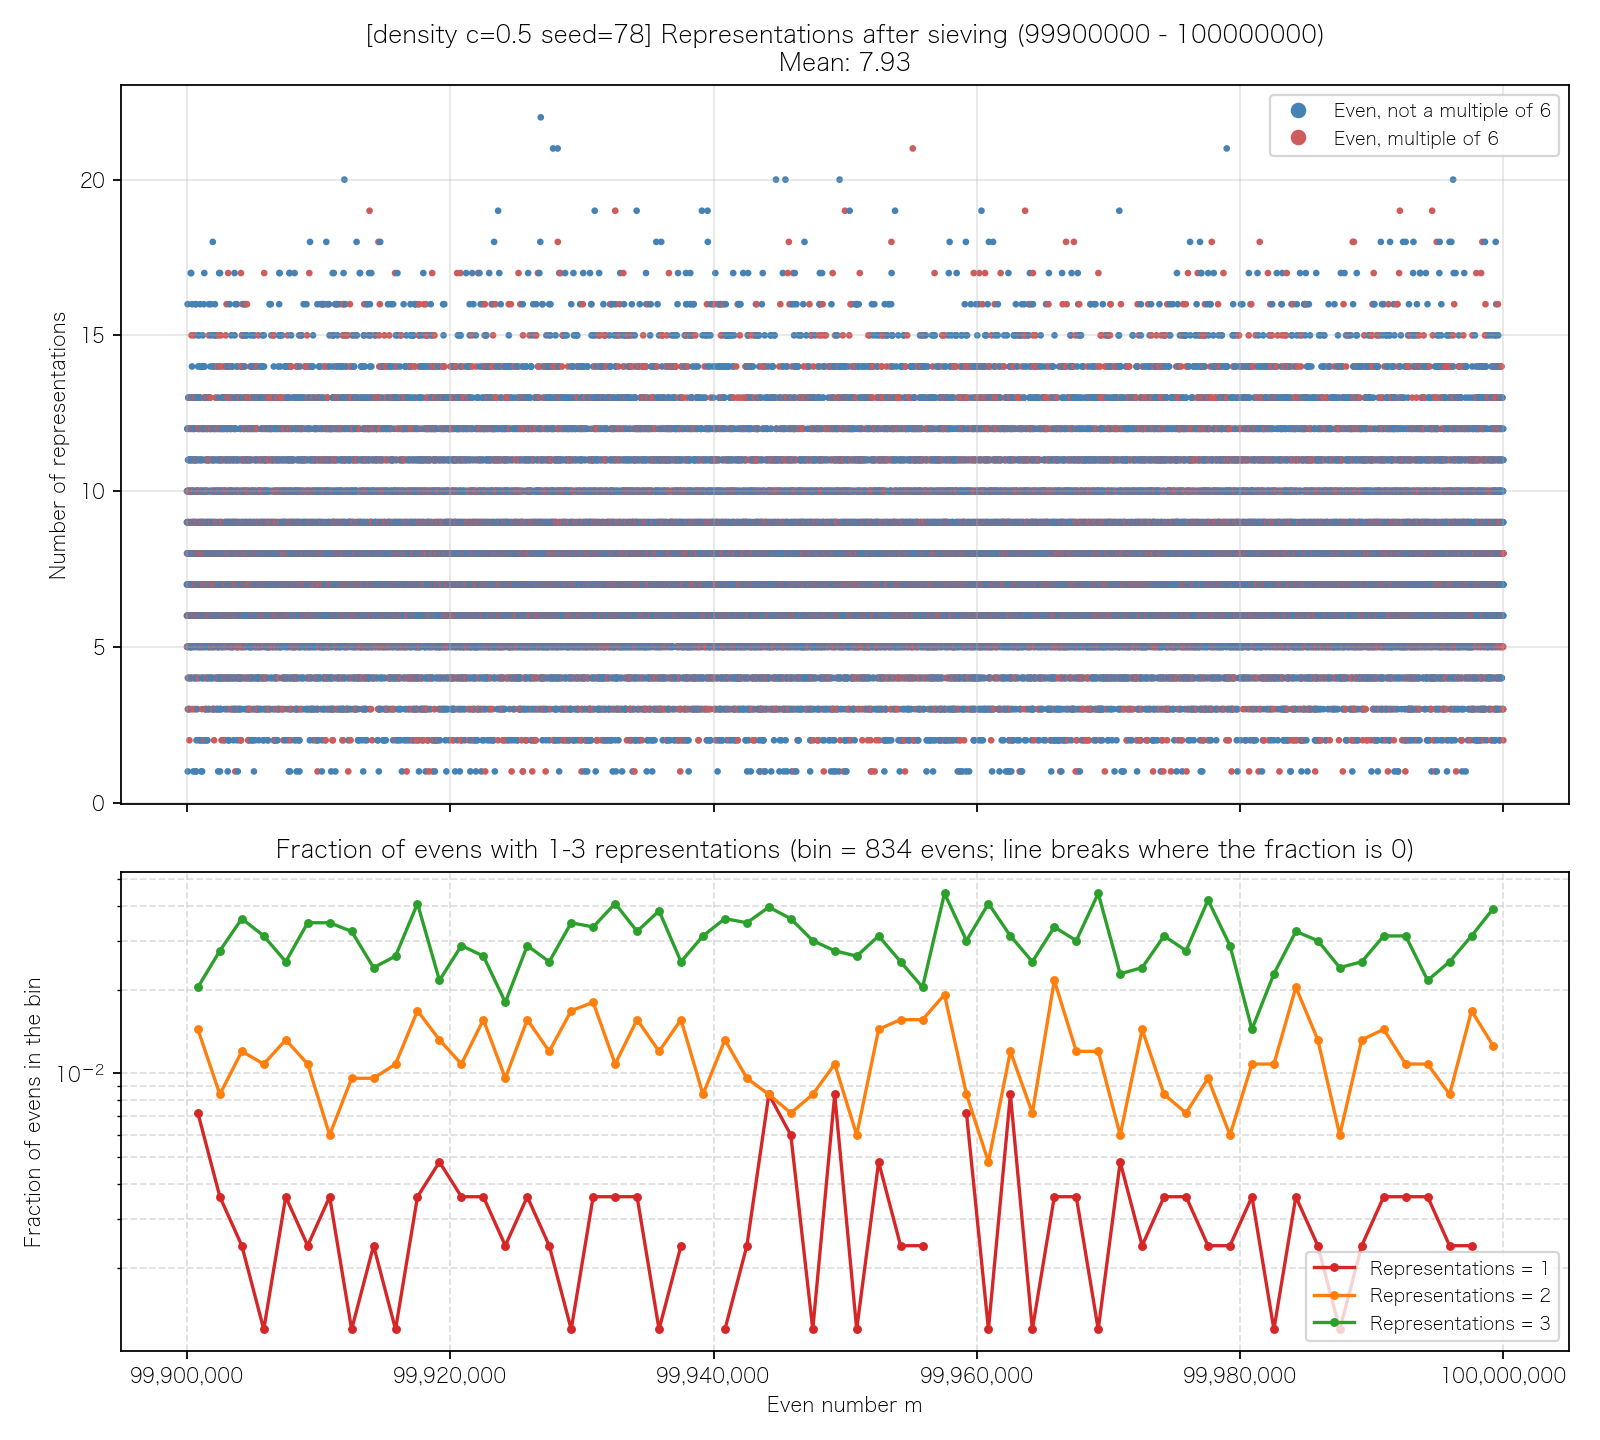 density=0.5 seed=78
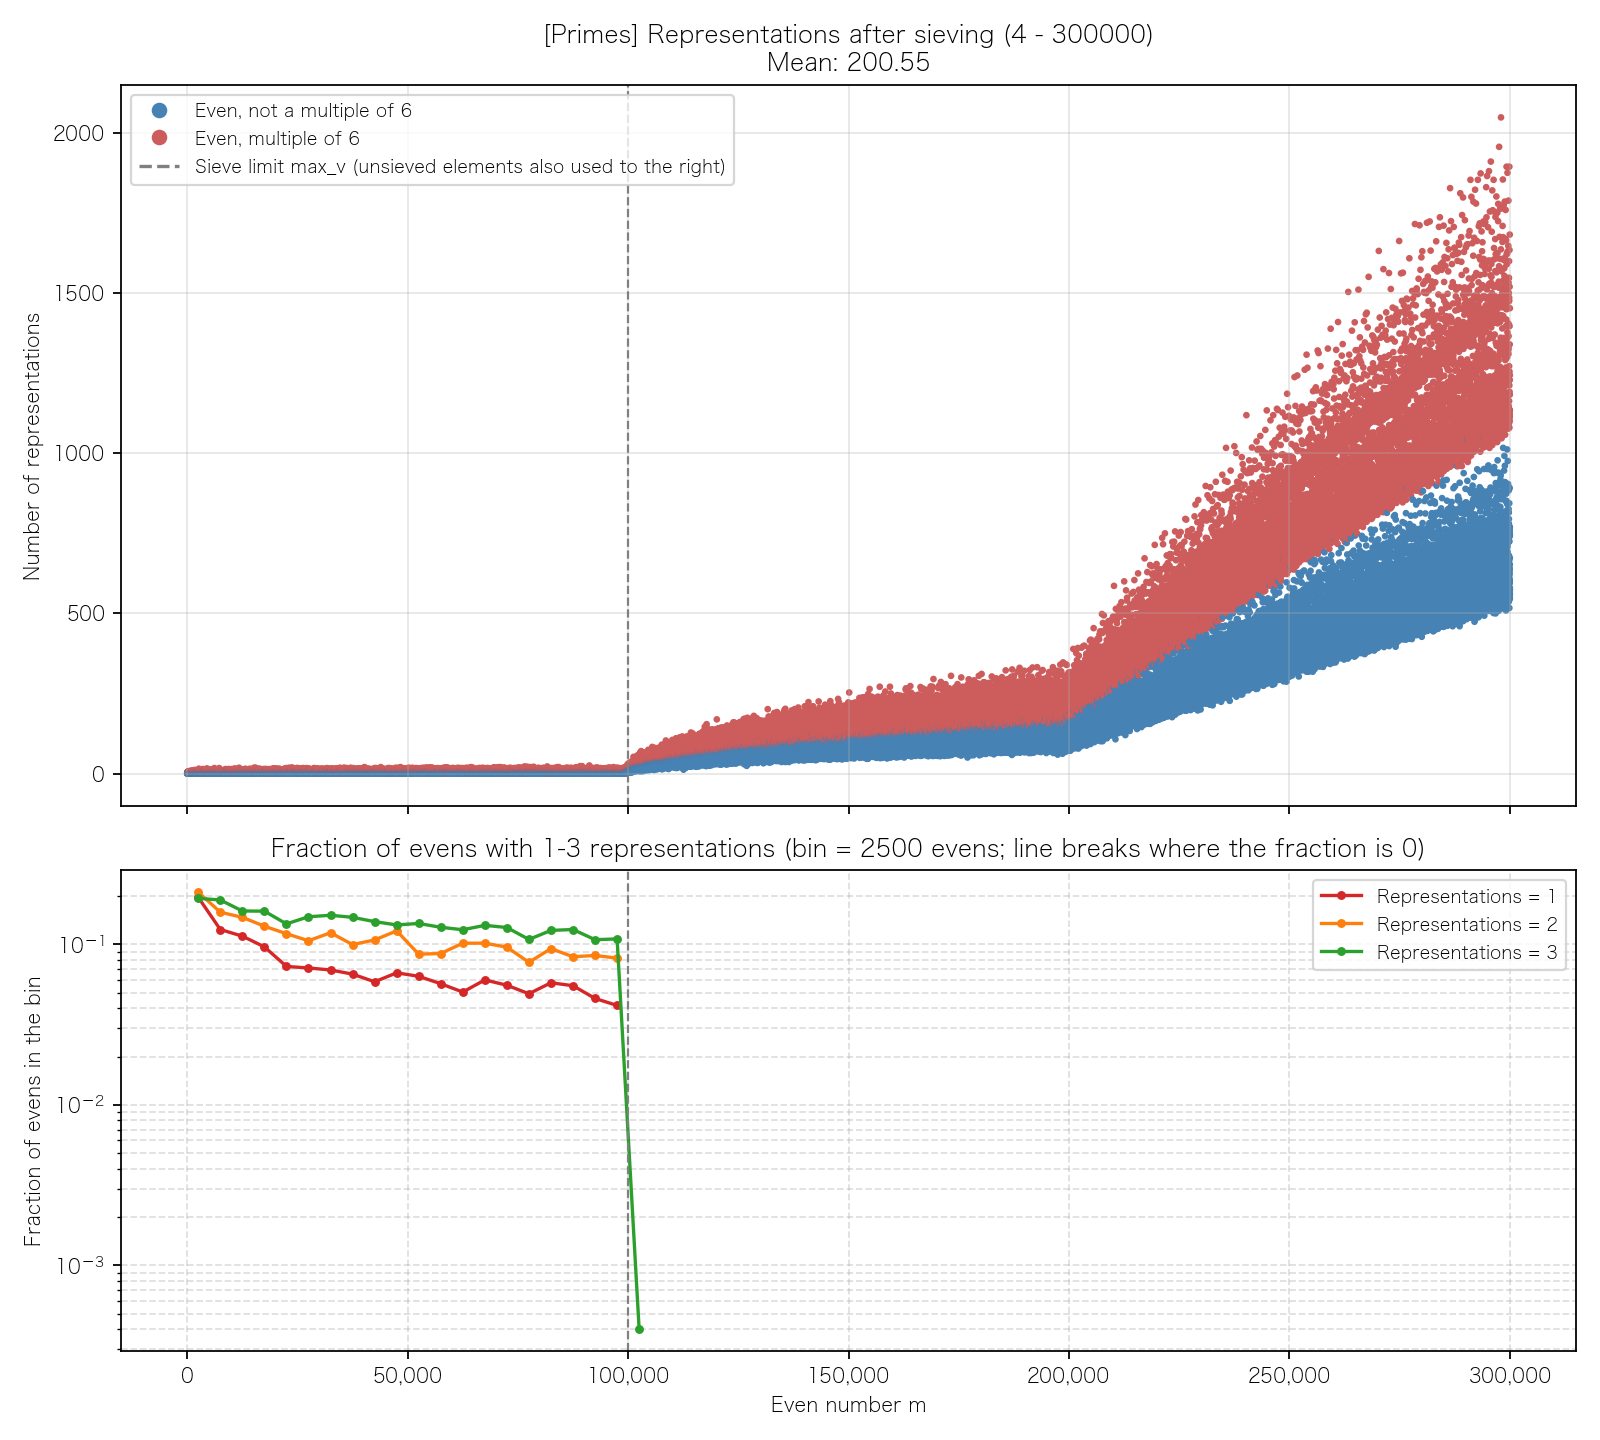 素数列 篩処理 m=$10^5$ まで
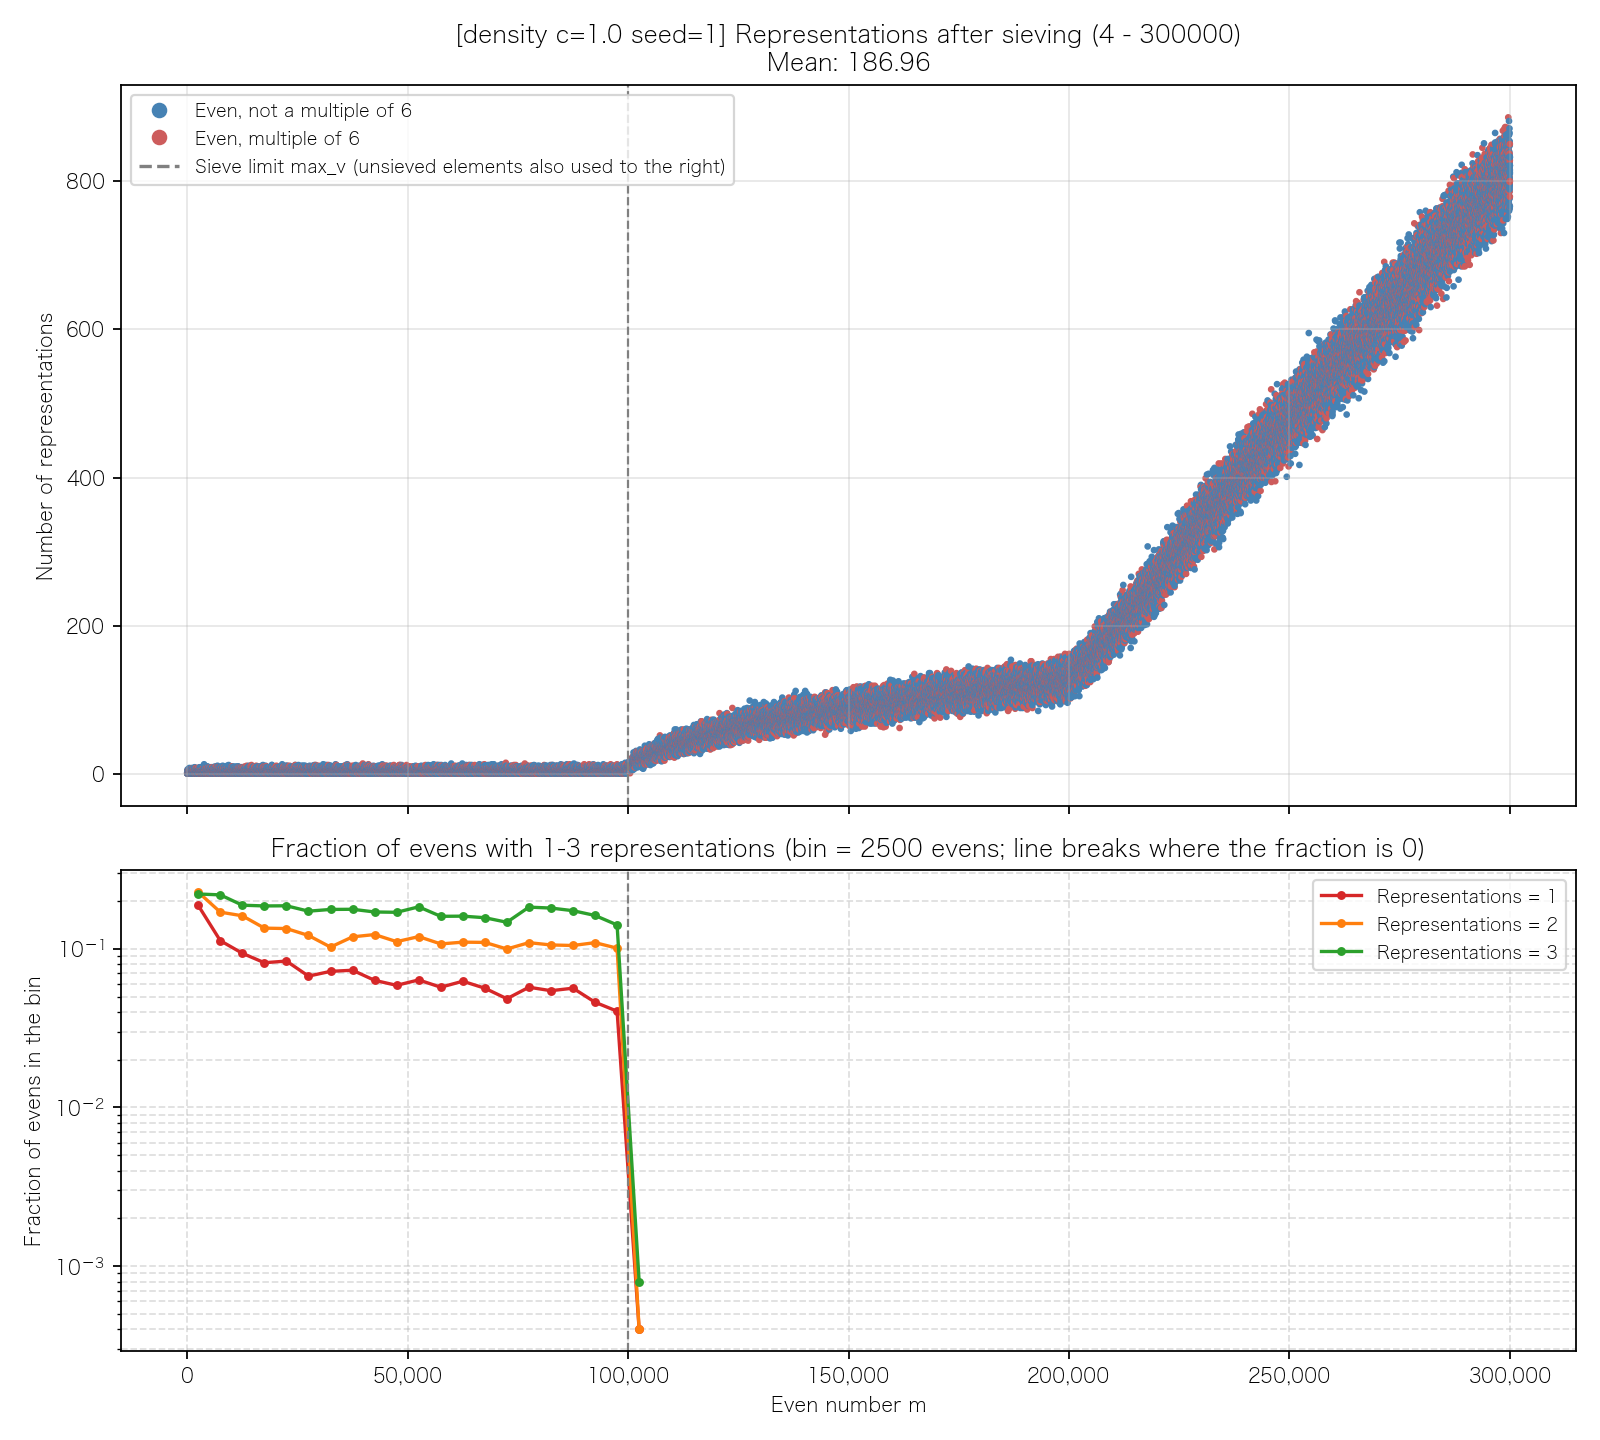 Cramér型奇数列(d=1.0 seed=1) 篩処理 m=$10^5$ まで
まとめ
[1]
・次の表のように、篩処理後の生存要素数は、m=$10^6$ ~ $10^8$ の実測値においては素数もCramér型も同じ増え方(指数約0.53~0.54)を示しました。
なお、Cramér型奇数ではプールの密度は完走率に影響しますが、図1~3のように篩処理後に残る核の大きさはプールの密度にほとんど依存していません。
素数
| m | $10^6$ | $10^7$ | $10^8$ |
|---|---|---|---|
| $m^{0.54}$(A) | 1,737.801 | 6,025.596 | 20,892.961 |
| 実測値(B) | 3,029 | 10,580 | 36,307 |
| B/A | 1.74 | 1.76 | 1.74 |
Cramér型奇数(density=1.0 seed=1)
| m | $10^6$ | $10^7$ | $10^8$ |
|---|---|---|---|
| $m^{0.535}$(A) | 1,621.810 | 5,559.043 | 19,054.607 |
| 実測値(B) | 2,672 | 9,199 | 31,355 |
| B/A | 1.65 | 1.65 | 1.65 |
・生存要素の密度は測定範囲においては概ね $m^{-0.46}$ 程度で減少する傾向を示しました。
この減少の傾向はプールの密度1/ln_m(素数定理)とは異なる特徴を示しています。
なお、Andrew Granville博士の疎らな素数集合によるゴールドバッハ予想の研究では薄い部分集合の密度は O($\frac{ \sqrt{m・log \:m} }{m}$) で表されますが、ここでの数値実験データもこれに類似する傾向を示しているようです。
・偶数4~mをすべて覆うには少なくとも約 $\sqrt{m}$ 個の要素が必要です。
篩処理を実行した後の生存要素の集合のサイズ c$\sqrt{m}$ を調べると、次の表のようになりました。
素数集合
| m | $10^2$ | $10^3$ | $10^4$ | $10^5$ | $10^6$ | $10^7$ | $10^8$ |
|---|---|---|---|---|---|---|---|
| c | 1.4 | 1.8025 | 2.25 | 2.6658 | 3.029 | 3.3457 | 3.6307 |
Cramér型集合(density=1.0 seed=1)
| m | $10^2$ | $10^3$ | $10^4$ | $10^5$ | $10^6$ | $10^7$ | $10^8$ |
|---|---|---|---|---|---|---|---|
| c | 1.5 | 1.8025 | 2.11 | 2.4033 | 2.672 | 2.909 | 3.1355 |
cはmとともに単調増加していますが、生存要素数の増え方によっては発散するか、やがて定数収束するかのどちらの可能性も残りそうです。
・次の表のように、素数集合とCramér型集合のどちらも平均表現数がmとともに増加し、両者の比もmの増加とともに大きくなる傾向を示しています。また、両集合の生存要素数の比の2乗は平均表現数の比と測定範囲全体にわたってほぼ一致しました。
生存要素数
| m | $10^5$ | $10^6$ | $10^7$ | $10^8$ |
|---|---|---|---|---|
| 素数集合 | 843 | 3,029 | 10,580 | 36,307 |
| Cramér型集合d=1.0 s=1 | 760 | 2,672 | 9,199 | 31,355 |
| 比 | 1.1092 | 1.1336 | 1.1501 | 1.1579 |
| 比の2乗 | 1.23 | 1.29 | 1.32 | 1.34 |
平均表現数
| m | 4~ $10^5$ | 4~ $10^6$ | 4~ $10^7$ | 4~ $10^8$ |
|---|---|---|---|---|
| 素数集合 | 5.32 | 6.94 | 8.52 | 10.09 |
| Cramér型集合d=1.0 s=1 | 4.35 | 5.40 | 6.47 | 7.54 |
| 比 | 1.22 | 1.29 | 1.32 | 1.34 |
なお、プール集合についても類似する結果が得られました。
※これらは同じ生存要素数のデータを異なる切り口から眺めたもので、各表の数値は独立した実験によるものではないです
※異なる選択規則や別の篩アルゴリズムを用いた場合にも同様の結果が得られるかどうかは、今後の検証課題です
[2]qの最大値は実験範囲内では比較的小さな値にとどまりました。ただしこの値は記録更新的に大きくなるので、範囲を広げると急に値が跳ね上がる可能性は残ります。
また、marginにかなり余裕がある傾向が確認できたので、もっと大きな範囲での実験においても篩処理が完走してくれるのではないかと期待してます。
[3]素数列もCramér型奇数列も篩処理後の小さな表現数(1,2,3)の偶数はmとともに枯渇していく傾向を示しました。その傾向は表現数1の偶数がもっとも大きく、次に表現数2,3の偶数の順でした。篩処理範囲内の表現数0の偶数はアルゴリズムの仕組みから存在しません。
[4]Cramér型集合は要素に3の倍数を多く含むため、6の倍数の偶数での表現数の増加(帯状構造)が現れないようです。
[5]無意識に都合の良いデータだけを採用しないように注意したつもりです。
私的な感触ですが、この数値実験を通じて当初の疑問について概ね肯定的な結果が得られたと思っています。当然それは、
$10^8$ 程度の小さな測定範囲内のデータから得た感触に過ぎません。
例えれば双眼鏡で天体観測しているようなものですね。
それはそれで楽しいのですが。
実験に使用したPythonコード
おわりに
このような稚拙なモノを最後まで読んでくださって有り難うございます。
この数値実験では壁打ちやコード生成にAIの力を借りています。

この記事を高評価した人
この記事に送られたバッジ
投稿者