4,313問の分野タグを集計する:重複計上と母数の扱い
複数タグを持つ問題データでは、「割合の合計が100%を超えた」こと自体は集計ミスではありません。問題数とタグ所属数を同じものとして扱ったときに、読み違いが起きます。
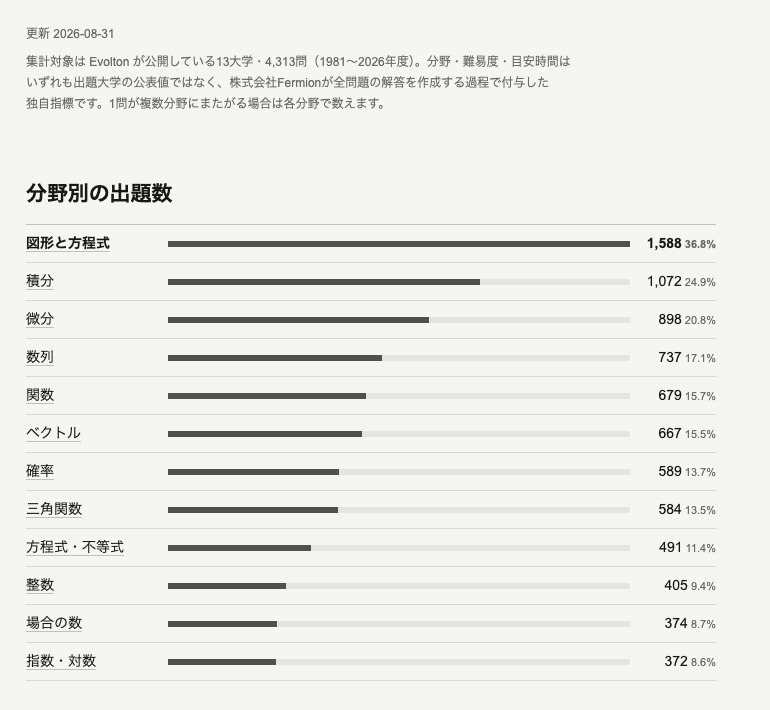 Evoltonの集計注記と分野別件数の棒グラフ
出典:Evolton 入試数学データベース。集計対象・重複計上の注記と分野別件数の棒グラフ。2026年9月1日取得。
まず小さなデータで確かめます。5問に次のタグが付いているとします。
| problem_id | tags |
|---|---|
| p1 | 図形、方程式 |
| p2 | 図形 |
| p3 | 方程式、確率 |
| p4 | 微積分 |
| p5 | 図形、微積分 |
異なる問題は5問です。一方、タグへの所属は 2+1+2+1+2=8 件あります。
タグ別割合はそれぞれ問題数5で割る
| タグ | 異なる問題数 | 5問に占める割合 |
|---|---|---|
| 図形 | 3 | 60% |
| 方程式 | 2 | 40% |
| 確率 | 1 | 20% |
| 微積分 | 2 | 40% |
合計は160%です。各行が「そのタグを持つ問題の割合」を表すため、同じ問題が複数行に現れます。100%へ正規化すると、今度は「全問題の何割にその分野があるか」という意味が失われます。
和集合なら問題を一度だけ数える
「図形または方程式が付いた問題」を数えるときは集合の和を取ります。該当するのは p1,p2,p3,p5 の4問なので80%です。
      |G ∪ E| = |G| + |E| - |G ∩ E|
          = 3 + 2 - 1
          = 4
図形3問と方程式2問を足した5問ではありません。p1 を一度引く必要があります。
SQLでは目的を二つに分ける
テーブルを problems(problem_id) と problem_tags(problem_id, tag) に分けた例です。
タグ別の問題数は次の形になります。
      SELECT tag, COUNT(DISTINCT problem_id) AS problems
FROM problem_tags
GROUP BY tag;
図形または方程式の和集合は、タグで絞った後に問題IDを重複除去します。
      SELECT COUNT(DISTINCT problem_id) AS problems
FROM problem_tags
WHERE tag IN ('図形', '方程式');
母数も同じフィルターから作ります。大学と年度を絞った分子を全4,313問で割ると、大学内割合でも全体割合でもない数になります。先に対象問題IDの集合 U を確定し、タグ件数と分母の両方を U から計算するのが安全です。
Evoltonの公開値へ当てはめる
Evolton Insights の対象は13大学、1981〜2026年度、4,313問です。 分野別ページ では「図形と方程式」が1,588問、36.8%と掲載されています。
1588 / 4313 × 100 = 36.8189...%
小数第1位へ丸めると36.8%です。ページの注記どおり、一つの問題が複数分野にまたがる場合は各分野で数えます。したがって分野率の総和は100%になる必要がありません。
もう一つ大切なのは指標の出所です。分野、難易度、目安時間はFermionの編集指標であり、各大学の公式評価ではありません。大学別比較では収録年度数も違います。件数だけで「出やすい」と判断せず、同じ期間、同じ入試区分、同じタグ定義にそろえた割合を確認します。
集計表に最低限残すべきものは、対象問題IDの条件、分母、タグ版、集計日、重複の扱いです。この5項目があれば、数値が更新されたときに差分を追えます。
このMathlog版は、株式会社Fermionが運営するEvoltonの集計資料を基に、同社が管理する「TeX64 Prime」から公開します。本文・数値・分類の誤りは
Evoltonの運営情報・訂正窓口
で受け付けています。

この記事を高評価した人
この記事に送られたバッジ
投稿者